
电脑上的杂事,往往要等出了问题才会处理。小编那台用了三年的 Windows 11 电脑,一查有 40 多个软件等着更新,项目文件没有任何备份、全靠 SSD 的健康状况撑着,每次网络出问题,也总变成“到底是自家网络还是网站的问题”的猜谜游戏。
这些事都不难,但都很烦,而烦人的重复活正适合交出去。小编的做法是:交给跑在自己 RTX 4070 Ti Super 上的本地模型,通过 Hermes Agent 来干。结论是,这三件事都能搞定,数据不出本机,也不烧云端额度。
当然也可以让 Claude 这样的前沿模型全包,但定期跑这类任务会不断消耗额度,要么按 API 价格额外花钱,要么就是真正需要模型时可用额度变少。
本地模型帮小编处理软件更新
Qwen3.6 跑 winget,小编只负责挑选
小编用的是 Unsloth 的 UD-IQ4_XS 量化版 Qwen3.6-35B-A3B,通过 llama.cpp 提供服务,上下文窗口 64K,用 –fit 参数把专家层分摊到 16GB 的 GDDR6X 显存和 32GB 的 DDR5-6000 内存上。在 Hermes Agent 中的实测速度约每秒 56 至 58 个 token。
第一件想交出去的是积压的更新。小编让 Qwen 运行 winget(Windows 11 自带的包管理器),列出所有待更新的软件。llama.cpp、Hermes 和英伟达驱动被排除在外,因为任务进行中更新它们,会把模型、智能体或显卡从任务下面抽走。
Qwen 返回了 40 多个软件,附带包 ID 和版本。出于同样的原因(Hermes 依赖它们),小编也没选 Git 和 Windows Terminal,只让模型更新了 WinRAR、HWMonitor 和 GPU-Z,都是小编平时常用的工具。每个软件的升级耗时 24 到 40 秒,整件事用了 1 分 42 秒,模型还自己生成了一张汇总表。
项目备份每晚自动跑
用 robocopy 搭建,由 Windows 每晚执行
备份这件事,忘了就是风险;个人电脑上要天天记得,更是负担。小编一直觉得 AI 最好的用法之一,就是替您记住您会忘的事。
于是小编让 Qwen 每晚 11 点把项目文件夹备份到另一块 SATA 固态硬盘(Crucial BX500),并要求用 robocopy(Windows 自带的文件复制工具)且只复制、绝不删除。它 2.3 秒复制了七个文件,并注册了一个 Windows 计划任务,所以备份不依赖模型,模型离线也照常运行。
让小编有点意外的是:小编并没有指定用哪个调度器,Hermes 本来自带一个。但 Qwen 选择绕开它,改用 Windows 计划任务,由 Windows 负责晚上 11 点的备份,而不是智能体。
网络排查不用再操心
Qwen 跑测试,小编看一句话结论
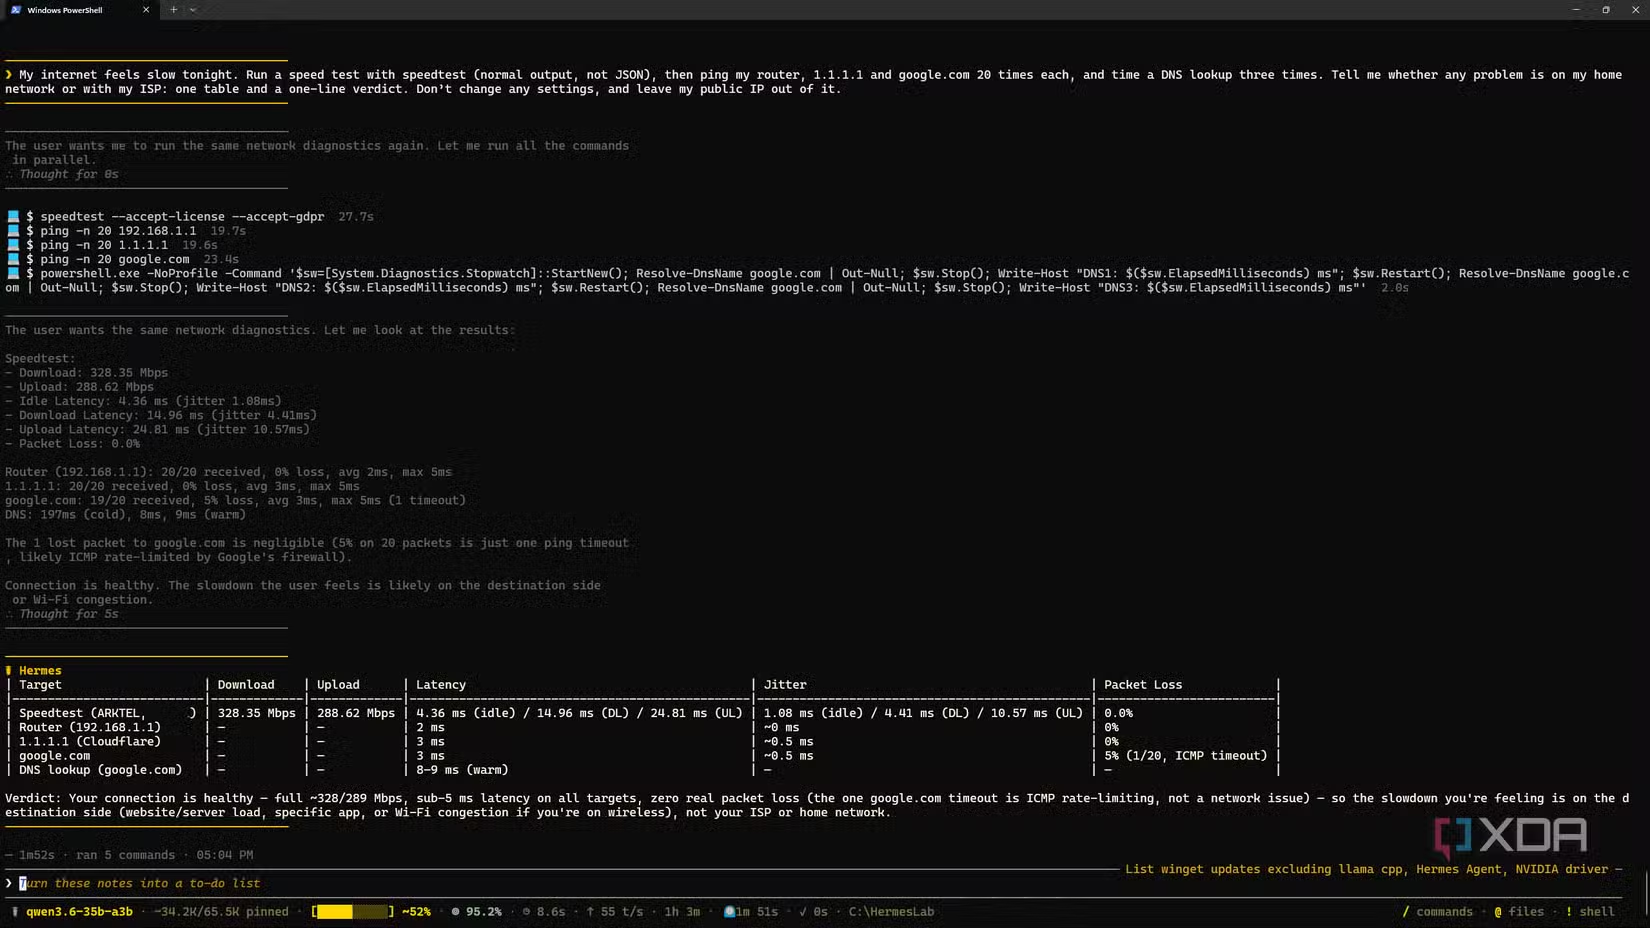
网站卡顿、在线服务打不开、玩射击游戏时延迟飙升,小编脑子里总是同样的问题:是 Wi-Fi、运营商,还是服务商自己?要回答,得跑测速、对路径上几个点 ping,再把数字对照着看。
为了省掉这个麻烦,小编让 Qwen 运行 Ookla 的 Speedtest 命令行工具(它自己通过 winget 装好),然后对路由器、Cloudflare 的 1.1.1.1 和 google.com 各 ping 20 次,再给 DNS 解析计时三次。整个检查共五条命令,约 1 分 44 秒。
最近的微软故障就是很好的例子:小编看到的报道称,自周四起 Outlook 瘫痪,Teams 和 Copilot 在 74 个国家受到影响。Outlook 加载不出来,您多半会先怀疑自己的网络,甚至先打电话给运营商。小编在故障未解决时让 Qwen 跑了一遍检查,不到两分钟就确认家里网络和运营商都没问题,嫌疑只剩对端。
本地模型还能做更多
当然,用 Claude 或 OpenAI Codex 这类付费服务来自动化这些事会很轻松,但每项任务都会把数据发到别人的服务器上,还要消耗 token 余额,说白了就是花钱。跑在自家显卡上的智能体几乎零成本,全在本地完成。随着英伟达 Nemotron 3.5 Bolt E4B 这类模型出现(为工具调用设计,只占 4GB),几乎任何台式机或笔记本都有了可用的选择。想看更多本地模型的实战,可以读16GB 显卡跑 Qwen3.6 对比 Claude Code。
常见问题(FAQ)
让本地 AI 更新软件安全吗?
建议排除 llama.cpp、Hermes、显卡驱动和 Git 等任务依赖的软件,再让它更新,不然任务会中途断掉。
备份为什么用 Windows 计划任务?
这样备份由 Windows 执行,不依赖模型是否在运行。
robocopy 会不会误删文件?
小编要求它只复制、不删除,按这个设置不会清除备份盘中的文件。
这套配置需要什么硬件?
小编用的是 16GB 显存加 32GB 内存;显存较小的机器可以选更小的模型,比如 4GB 级别的工具调用模型。
和云端模型比哪个更划算?
常规杂事用本地模型几乎零成本,需要更强能力时再用云端。