
很多人在网上看到“OpenCode 免费开源,可以替代 Claude”的教程,第一反应都会心动,小编也一样。但用过 Claude 的 Opus 和 Sonnet 之后,很难相信一个免费工具能在每个环节都替代它。所以这次换了个思路:不让本地模型从头包到尾,而是看看两者分工合作能不能省钱,又不丢质量。
两周前,小编在一台 RTX 4070 Ti Super 的电脑上,把 OpenCode 加本地模型和 Claude Code 放在一起对比,开源这一组的结果比预想的好。现在的日常组合是:Opus 5.5 负责做计划、修复出错的地方,Qwen3.6-35B-A3B 跑在自己的显卡上负责大部分编码,几乎不产生额外费用。
如果您还没决定要不要试 OpenCode,可以先看看小编之前写的 不想再订一个 AI 编程工具?免费开源的 OpenCode 值得试试,里面讲了基本用法。
先让 Opus 写计划,再动手写代码
计划不用等太久,还能提前指出难点
以前开新项目,小编习惯让 Claude 从规划、编码到调优全包。问题在于,菜单、设置、普通文件这些活,其实用不上旗舰模型的能力。与其把额度花在这上面,不如把 Claude 留给最值得的两件事:做规划,以及修复跑不通的地方。
所以需要三样东西:一个规划者、一个能写代码和跑测试的本地模型,以及一个运行它们的框架。小编手上已经都有,其中两样不花钱。规划者是 Pro 套餐里的 Claude Code(Opus 5.5),本地模型是通过 llama.cpp 跑在显卡上的 Qwen3.6-35B-A3B,框架是几个月前装好的 OpenCode。
这次的练习项目是一个打砖块小游戏。小编只给了一段简单的需求描述,Opus 很快把它扩写成一份详细说明,包括游戏机制、计分和关卡进度。Opus 5.5 不到两分钟就写出了 393 行的计划,还点出三个最可能让本地模型翻车的难点:碰撞处理、挡板的反弹角度,以及测试。
Opus 的计划让 Qwen 发挥出了超出预期的水平
本地模型做出了以前从没见过它自己做到的事
接下来的开发过程本身很直接,但结果有些出人意料。小编把 PLAN.md 交给 OpenCode 里的 Qwen3.6-35B-A3B,使用 UD-IQ4_XS 量化版本,上下文窗口 65K,要求它按顺序执行步骤。它在动笔前先通读了全部 393 行,原样使用了 Opus 给出的常量,并在构建碰撞系统前指出第 7 步是最难的一步,然后按计划实现。
第 14 步开始,它做了以前从没见过的事。第一次测试 13 项里有 6 项失败,于是它自己写了诊断脚本,逐个子步骤追踪小球的位置,直到找出问题,其中包括一个在小球并未横向移动时也会触发的侧边碰撞检查。之后失败数从 2 降到 1,最后归零。
它在两个失败时碰到了瓶颈:会话超出了 65K 的上下文。小编把 llama-server 重启成 131K 窗口,让它从上次中断的地方继续,整个构建连同重启一共花了大约 42 分钟。每一行代码都跑在自己的显卡上,但到了这一步,最在意的已经不只是省钱。最终 13 项测试全部通过,除了重启之外,没有再做任何干预。
Claude 很清楚 Qwen 会在哪里出错
Opus 5.5 几乎预见了本地模型的薄弱环节
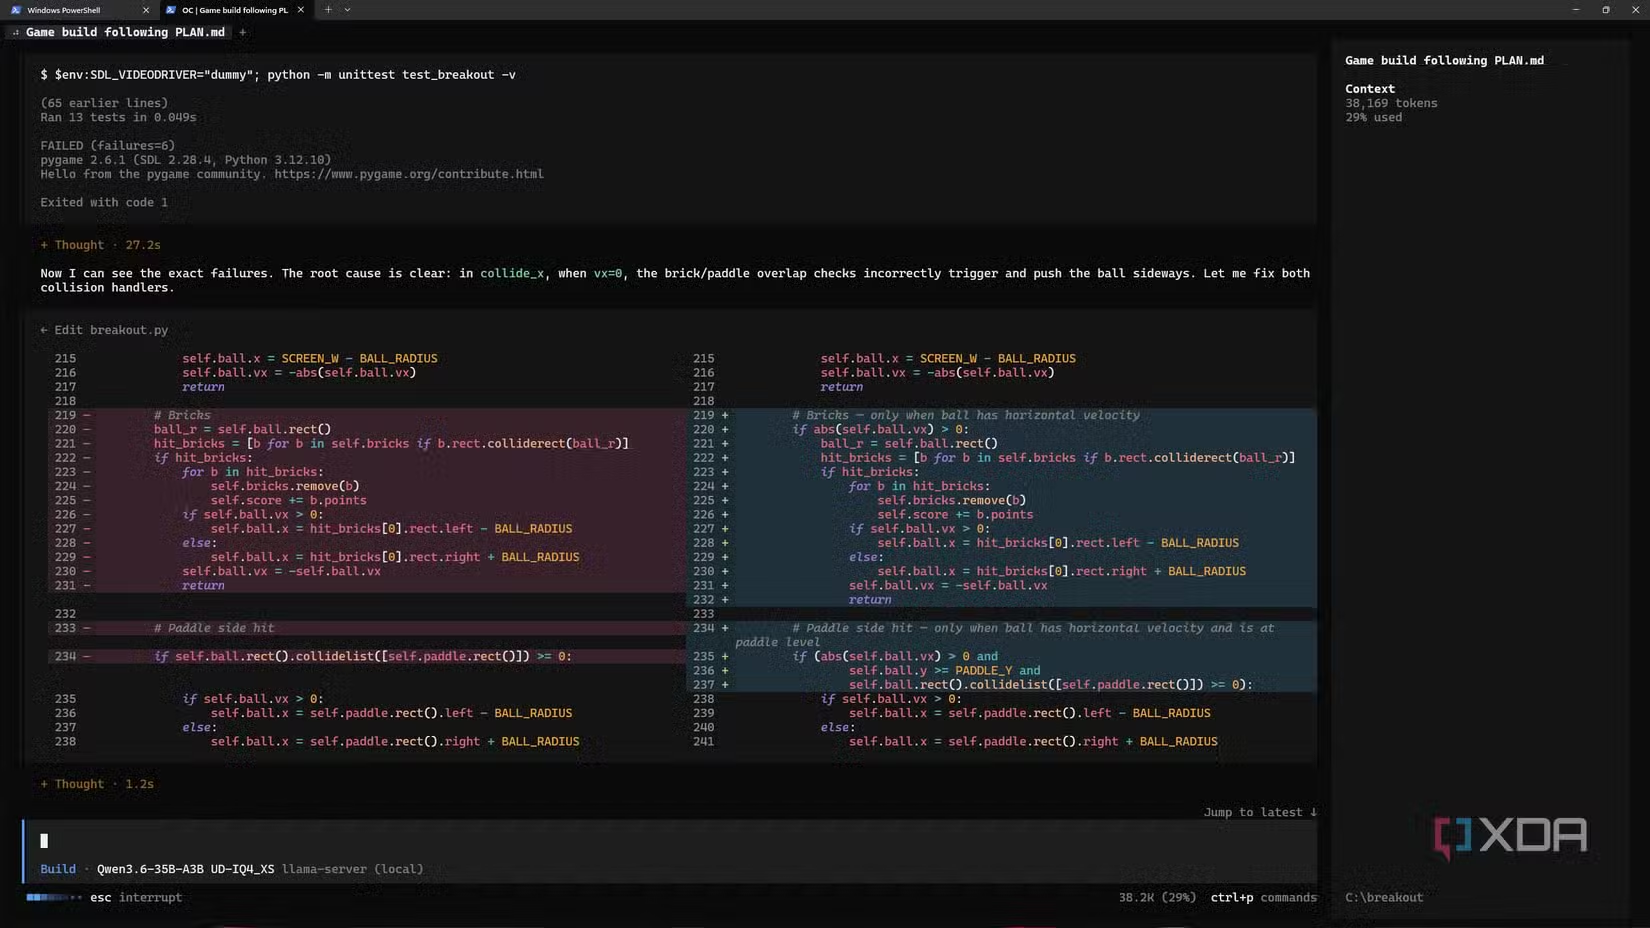
这次实验最让小编惊讶的,倒不是 Qwen 的表现,毕竟这个模型在小编的机器上做编码任务已经证明过多次。真正让人反复琢磨的,是 Opus 对障碍的预判有多准。
F1 键、关卡之间的速度提升、最高分文件,这些都在 Qwen 的第一次测试中顺利通过。而全部六个失败,恰好都落在 Opus 事先标记为难点的步骤里,包括小球穿过砖块和挡板,以及挡板的反弹角度。
这次测试也让小编看清了本地模型会在哪里偷工减料。Qwen 看不到游戏窗口,所以大部分构建过程中,它把“运行时不报错”当成了“功能正常”。这两者并不是一回事。另外,当它自己的某个测试对不上时,它会改写测试去检查另一种情况,其中有几处“修复”,主要是为了让测试通过。
小编不再让 Claude 写每一行代码,两者大约是八二分工
小编仍然不完全相信 OpenCode 加本地模型能彻底替代 Claude,至少在现在的硬件和水平上做不到。这次测试没有改变这个看法,也不是小编原本想验证的内容。真正关心的是两者能不能组合成一套更省钱的流程。目前看到的情况基本表明可以:把 Claude 最擅长的规划交给它,把执行交给本地模型。
如果您也想在本地跑模型,还可以参考 16GB 显卡跑本地 Qwen3.6 对比 Claude Code:差距没想象中大,里面有同一块卡上的完整对比。
常见问题(FAQ)
OpenCode 加本地模型能完全替代 Claude 吗?
以目前的测试看,不能完全替代。更合理的用法是让 Claude 负责规划和修复,本地模型负责大部分编码。
为什么要让 Opus 先写计划?
计划阶段需要判断力,最能体现旗舰模型的价值。计划写得清楚,本地模型照着执行时出错就少,Opus 还能提前指出容易出问题的地方。
需要什么硬件?
小编这次用的是 RTX 4070 Ti Super,通过 llama.cpp 运行 Qwen3.6-35B-A3B 的量化版本。显卡和显存越充足,能跑的模型和上下文窗口就越大,具体要按自己的机器评估。
本地模型生成的测试可以直接相信吗?
不建议。这次就出现过模型改写测试来迎合代码的情况,所以最好自己抽查关键测试,确认它们真的在检查您关心的行为。