
家里的老笔记本换下来以后,扔了可惜,放着又占地方?小编的做法是把它留作 24 小时开机的家庭服务器,再让核显(CPU 里自带的那块集成显卡)跑一个小型本地 AI,专门帮家人看私人文档。结论先说:能用,但很慢,适合当后台小帮手,不适合当 ChatGPT 的替代品。
小编这台旧本子是宏碁 Nitro 5,配置是 RTX 3050 Ti(移动版)、酷睿 i7-11800H 和 16GB 内存。放在五年前还算不错,现在得精打细算。独显已经在忙 Jellyfin 转码和 Sunshine 串流,不想再让它多干一份活,所以 AI 任务只交给核显。
起因也很现实:小编发现爸妈经常把银行对账单、保险单、体检报告直接丢给 Gemini 和 ChatGPT 解释。方便是方便,可这类文件传到别人的服务器上,小编心里不踏实。
为什么要让 AI 只跑核显
简单讲,独显要留给更吃力的活。这台机器的 RTX 3050 Ti 已经被转码和串流占着,再加一个常驻 AI 进程,大家的体验都会受影响。核显平时基本闲着,拿来跑一个 2B 的小模型正合适。
小编的目标也不高:不做什么“私人 ChatGPT”,只要一个 2B 左右的模型,放在家里的私有服务器上,回答关于家庭文档的问题,数据不出家门。服务跑起来以后,同一个 Wi-Fi 下的手机、电脑都能访问,独显照旧去干转码和串流。
搭建思路:llama.cpp 加 Vulkan,模型选 LFM3-VL-2B
第一步:用 Vulkan 版 llama.cpp,把设备锁定到核显
llama.cpp 是一个轻量的本地推理工具,没什么花哨界面,所以很适合配置一般的老笔记本。想让它只用英特尔核显,需要用 Vulkan 编译版本,并把设备指定为 Vulkan0(也就是核显)。
怎么确认没碰独显?小编在跑模型时开了一个 nvidia-smi -l 1 每秒刷新,看到 llama.cpp 完全没出现在 RTX 的占用列表里,就算成功了。
第二步:选一个能看图的小模型
模型用的是 Liquid AI 的 LFM3-VL-2B。它是视觉语言模型(既能读文字也能看图片),这一点很关键,因为我们要让它看扫描件和截图,而不只是回答文字问题。使用它需要 llama.cpp 的 build 11960 或更新版本。
第三步:做成局域网服务
推理跑通后,把 llama.cpp 开成局域网服务,整个项目的意义就变了:它不再是小编一个人的玩具,而是全家都能访问的服务。笔记本用网线接路由器,小编在每个人手机上建了一个 Chrome 快捷方式,点一下就能打开聊天页面。
实测:慢,但够用
先把预期放低。这个小模型在核显上不会让人惊艳,推理能力也比不上 ChatGPT 或 Gemini。它适合的场景是:总结一份体检报告、梳理一份银行对账单,或者从不想细看的资料里提炼要点。需要细致推理的问题,它做不好。
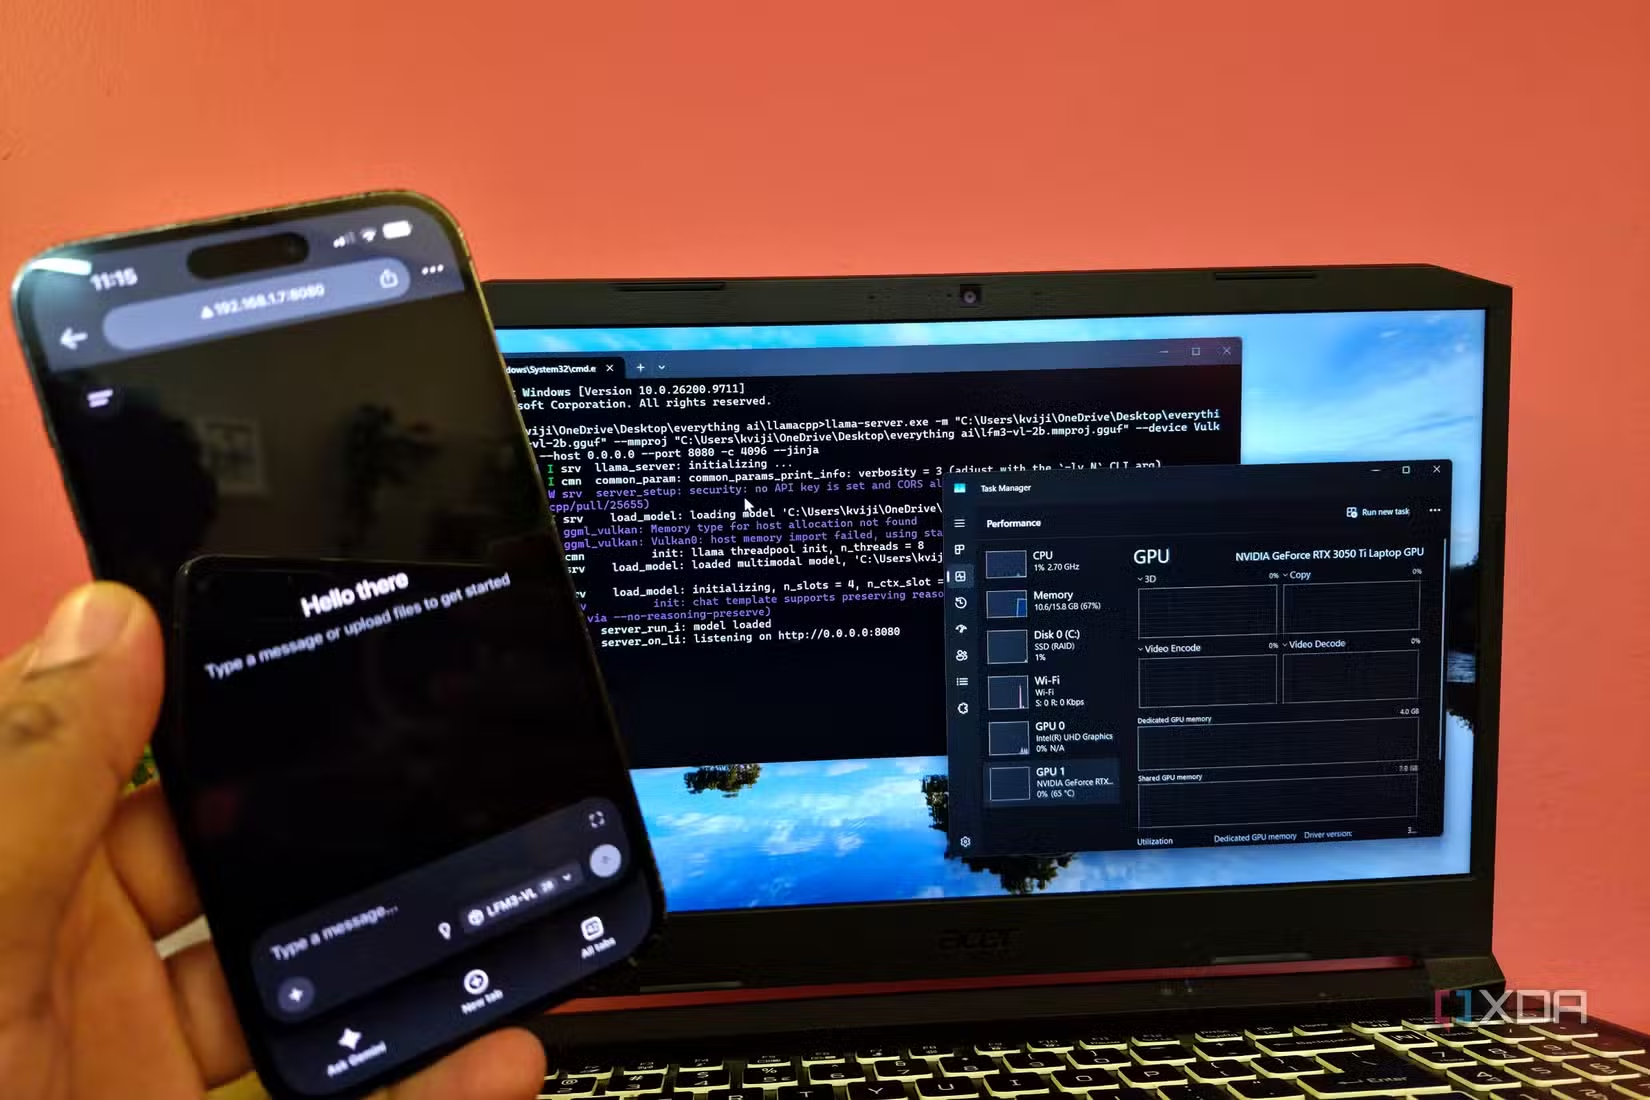
速度方面,生成文字大约每秒 6 个 token,倒还能忍。真正慢的是“读”:丢给它一份两页的扫描版租房合同,要等将近四分钟才开始出第一个字。下面是小编这次的实测数据。
| 项目 | 数值 |
|---|---|
| 输入 token 数 | 7,098 |
| 生成 token 数 | 252 |
| 输入处理速度(预填充) | 33.3 token/秒 |
| 首字等待时间 | 约 213 秒(3 分 33 秒) |
| 生成速度 | 6.11 token/秒 |
| 生成耗时 | 约 41 秒 |
| 从提问到完整回答 | 约 254 秒(4 分 14 秒) |
另外,LFM3-VL 目前不能直接处理 PDF,得先截图再上传,多出一个步骤。不过碰到真正敏感的文件,这点麻烦值得,而且这种情况本来也不多。日常的普通问题,爸妈还是用熟悉的 Gemini,他们已经用惯了。
速度慢在这个场景里影响不大。它是后台帮手,不是聊天机器人:笔记本放在角落默默运行,家里人用手机和电脑随时访问,敏感文件始终留在自己的网络里。
这套方案适合谁
说句实话,这套东西对大多数人未必划算。它没有性能可炫耀,跑分也不好看,就是刻意做得很朴素,只干一件不起眼但对家里有用的事。但对小编来说,这台旧笔记本因此比 2026 年的它“应该有的价值”更有用。想进一步了解类似思路,可以看看小编之前写的本地大模型读私人文档:LM Studio 加 MCP 实测,或者这 4 件事我只交给本地大模型做。想了解同一家公司的 Liquid AI 小模型在笔记本上的表现,还有一篇8GB 的 MacBook Air 离线跑 LFM3-Omni 实测。
想自己动手的话,可以对照官方文档:llama.cpp 项目主页里有 Vulkan 编译和 server 模式的说明,Liquid AI 官网可以查到 LFM 系列模型的最新信息。
常见问题(FAQ)
核显真的能跑 2B 的模型吗?
能,小编实测可以。不过速度有限,生成每秒约 6 个 token,读长文档要等几分钟。
怎么确认模型没占用独显?
用 Vulkan 版 llama.cpp 并指定 Vulkan0,再运行 nvidia-smi -l 1 观察,只要进程列表里没有 llama.cpp 就说明没用独显。
家里别的设备怎么访问?
把 llama.cpp 开成局域网服务,在手机或电脑浏览器里输入笔记本的内网地址即可,小编是在手机上建了 Chrome 快捷方式。
能直接上传 PDF 吗?
目前不行,LFM3-VL 不直接处理 PDF,需要先截图再上传。
能完全替代 ChatGPT 或 Gemini 吗?
不能。它更适合做总结和提炼要点,复杂推理还是云端大模型更强,建议只把真正敏感的文档交给它。