
8GB 显卡只够同时放一个像样的本地模型,当天来什么活都交给它,不管合不合适?小编也这样过:每周把默认模型换大换小,回答不好就怪当时加载的那个。结论先说:把任务拆开,给不同工作配不同模型,小编现在用 Qwen 3.5 4B 管日常和研究、Qwythos 9B v2 管推理、Fluently Qwen3-Coder 4B 管代码,整体更快也更好用。
原因很简单:小模型跑得快,但面对重活或多步骤任务会吃力;换大一点的模型,随着会话变长,每个小问题又都变慢。小编花了很久才回头看自己究竟让这些模型干什么,发现很多任务根本没什么共同点。
分工一览
| 模型 | 负责什么 | 体积和特点 |
|---|---|---|
| Qwen 3.5 4B | 日常问答、截图、通过 Brave 搜索和抓取工具做研究 | 4 位量化约 3GB,约为 9B 的一半,能放更长上下文 |
| Qwythos 9B v2 | 多轮对话和复杂推理 | Q4_K_M 文件约 5.7GB,RTX 3070 可完全放入 |
| Fluently Qwen3-Coder 4B | 代码及代码相关小活 | 4 位版本约 2.4GB,只处理文本 |
日常任务:Qwen 3.5 4B 取代 9B
看过小编本地模型文章的朋友大概知道,Qwen 3.5 9B 是小编的主力,当初同事推荐它,是因为小编还在为 gpt-oss 20B 发愁。阿里 Qwen 团队三月发布了四个小号 Qwen 3.5 模型,其中 4B 和 9B 是图文一起训练的,所以截图在这两个上都能用。
换小的并非必须,9B 在小编的显卡上本来就跑得不错,但小模型更快:模型每生成一点文字都要读完全部权重,4B 的权重不到 9B 的一半。上下文也有关系:本地模型一般用压缩的 4 位版本,4B 大约要 3GB,约为 9B 的一半,剩下的空间能把上下文窗口推到远超小编常用的 30K。
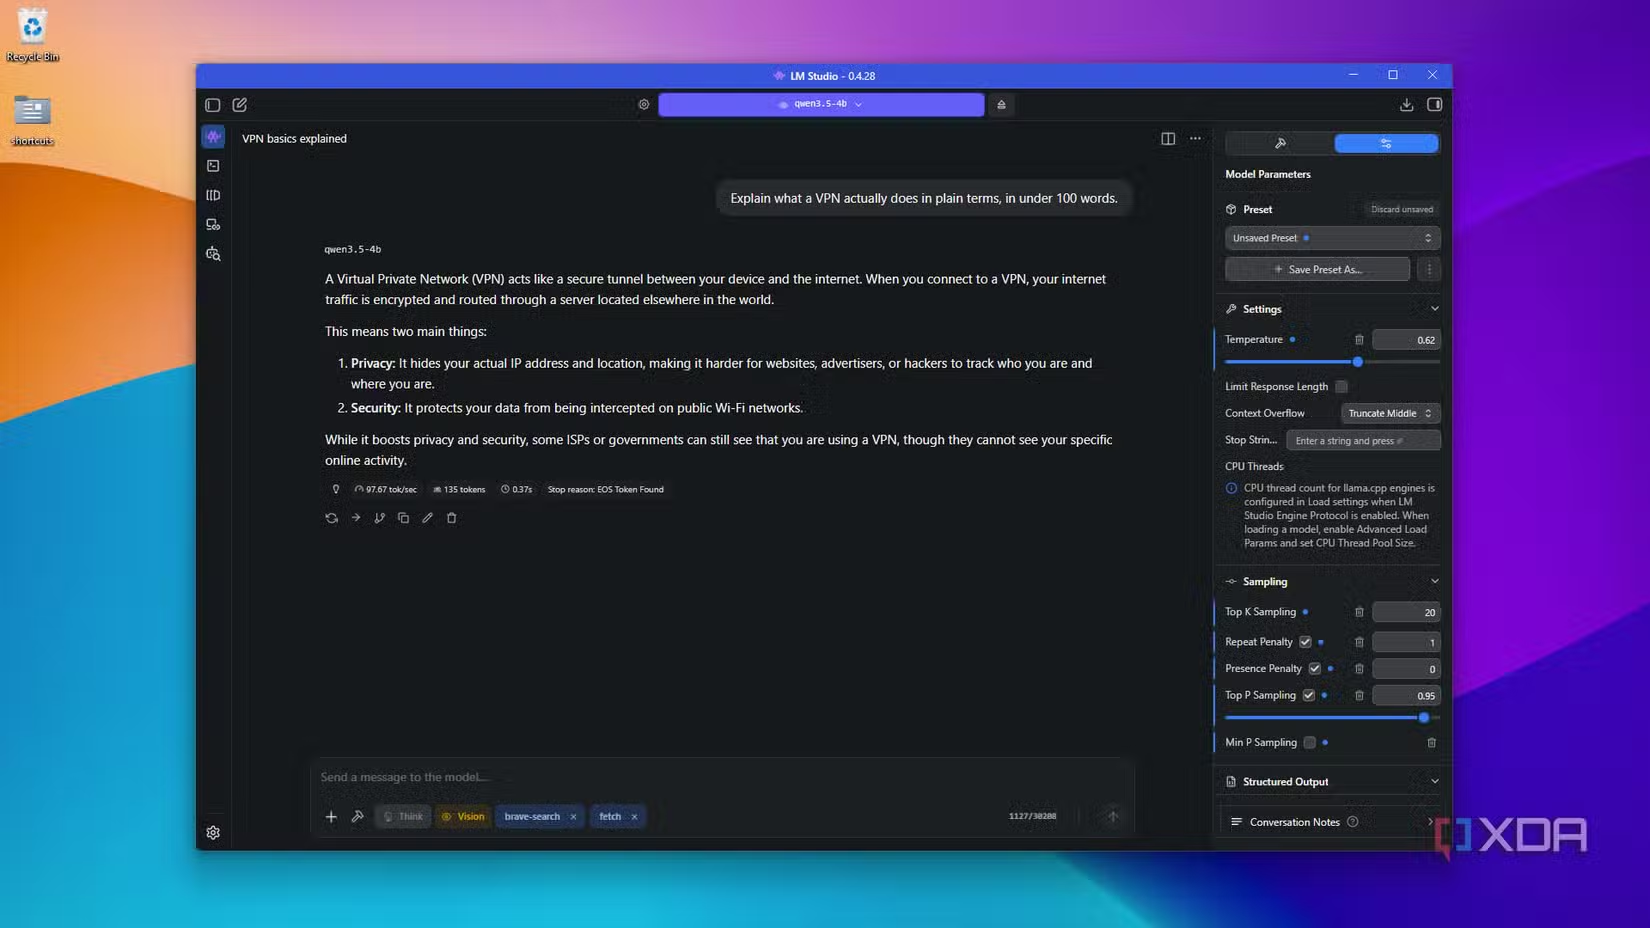
现在它接手以截图开头的任务,以及不想发给云端的小问题。小编手机上也装了 4B 和 2B,把体检结果、银行对账单直接从各自的手机应用导出,在本地查询。但小模型有个要注意的习惯:Artificial Analysis 测试 4B 时发现,不知道答案时约 80% 的情况下它会瞎猜而不是说不知道,所以最好给它接一个联网工具。
推理担当:Qwythos 9B v2
Qwythos 9B v2 是小团队 Empero AI 基于同一个 Qwen 3.5 9B 做的社区微调,重新训练成先推理再回答。v2 是因为原版爱重复自己,Empero 测试显示 v2 的循环率为零。它已经开始取代小编原来做通用聊天主力的 Gemma 4,回答方式有点像 5 代之前的 Claude Sonnet,配上仿 Claude 风格的系统提示词后更强。
| 测试(Empero 自报) | 基础 9B | Qwythos 9B v2 |
|---|---|---|
| GSM8K(小学数学应用题) | 80.6% | 93.6% |
| GPQA-diamond(研究生级科学题) | 32.8% | 49% |
这些是官方自报数字,但和小编处理分步问题时的感觉吻合。现在涉及大量来回讨论的对话,比如重新设计作品集或整理研究文档,都交给 Qwythos。它的弱项是图片,这类仍交给 Qwen;代码也不是它的强项。
给不写代码的人配一个小代码模型
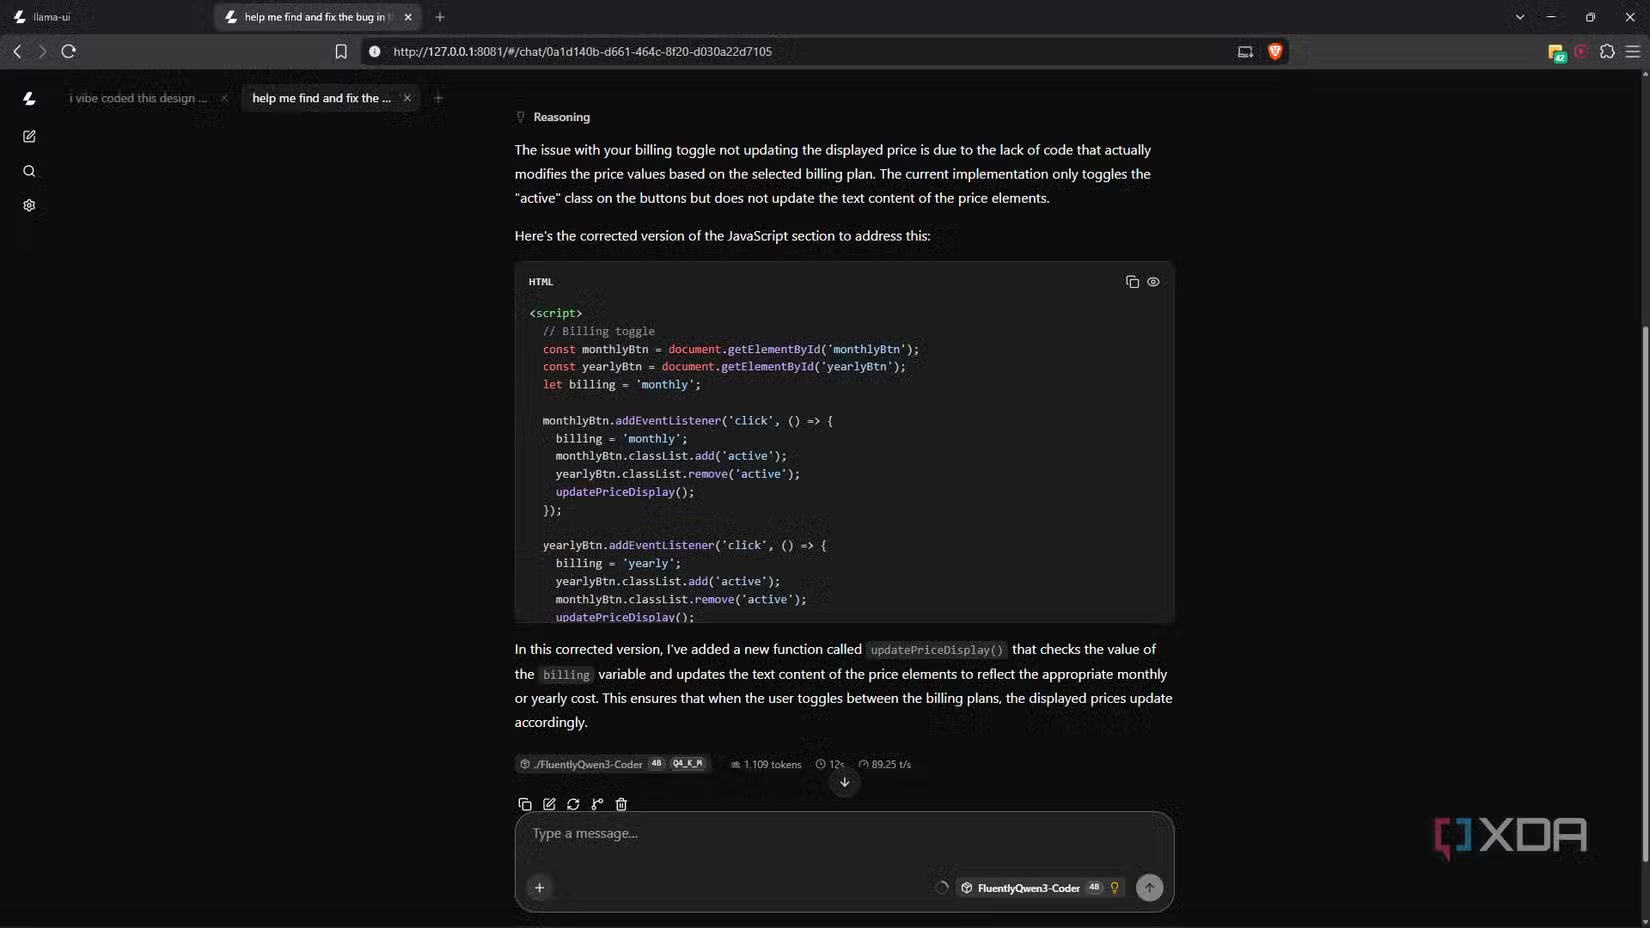
小编不写代码,正因如此才留一个专为代码调过的模型,毕竟确实需要帮忙。小编的“编程”多是 YAML、JSON、正则这类边缘活,最近也开始让 AI 帮忙写几个自用的 Python 小工具,GitHub 上拿来的脚本也先交给它,让它在运行之前解释会对电脑做什么。
FluentlyQwen3-Coder-4B 是 Project Fluently 基于 Qwen3 4B 的社区微调,比另外两个模型早一代,专为写代码训练。Qwen 官方没有这么小的编程模型,所以 4B 档基本只能选社区版。小编用的是 mradermacher 在 Hugging Face 上的 4 位版本,约 2.4GB。以前这类活落到当时加载的通用模型上,并不明智;需要大力气的活仍然交给 Claude,小而私人的编程活现在交给 Fluently。
小结:少给每个模型一点活,反而更好
推理和代码有了归属,Qwen 3.5 4B 就剩一个主要工作:通过小编加到运行器里的 Brave Search 和抓取工具做研究,并处理日常问题。它会先搜索、读页面再回答,推理也不错。小编觉得它体积小带来的上下文余量,比任何跑分都重要。想自己试,可以看 Qwen 官方 Hugging Face 主页 和 LM Studio 文档。
常见问题(FAQ)
8GB 显卡能同时放三个模型吗?
一般是按任务切换加载,不是同时放,按需换用,每个模型都不大,切换也快。
小模型不知道答案会怎样?
据 Artificial Analysis 测试,4B 约 80% 的情况会瞎猜,所以要接联网搜索工具。
Qwythos 为什么用 v2?
原版爱重复自己,Empero 称 v2 的循环率为零。
要不要都换成更大的模型?
在 8GB 显卡上大模型会让每个小问题变慢,小编更推荐按任务分工。