
用 Claude 写代码,写到一半被“五小时额度用完”打断,您是不是也干过直接充值续上的事?小编有位网友在一个月里这么干,在每月 20 美元的 Pro 套餐之外又多花了 300 多美元。他后来换了个思路:让本地显卡先把代码框架写出来,再交给 Claude 收尾。简单讲,云端模型只干最关键的活,其余交给本地模型,费用能省下近一半。
根据 Menlo Ventures 2026 年的报告,企业在 AI 上的支出已从上年的 330 亿美元涨到 1770 亿美元(截至 9 月),其中 Claude Code、OpenAI Codex 这类编程工具就占了 240 亿美元。个人用户的账单,其实就是这个趋势的缩小版。
五小时额度,其实是个“收费站”
Claude 同时有两道额度:每五小时重置一次的会话额度,外加一个每周额度。聊天和 Claude Code 共用同一份,任何一道用完都得等重置。
Anthropic 也给了“花钱解决”的办法:最低 5 美元就能充值使用额度,之后按 API 价格计费,可以设月度上限,也可以开自动充值。问题就出在自动充值上,余额低于阈值就自动买,账单会悄悄涨上去,还不会问您一声。
| 模型 | 输入价格(每百万 token) | 输出价格(每百万 token) |
|---|---|---|
| Fable 5.1 | 10 美元 | 50 美元 |
| Fable 5.2 | 8 美元 | 40 美元 |
Fable 5.1 的价格是 Opus 5.5 的 2.5 倍。在 Pro 套餐上,Fable 5 和 5.1 不占用套餐额度,从第一个 token 起就走使用额度;Fable 5.2 同样如此。唯一的例外是发布首周,三款 Fable 模型都计入 Pro 额度(最多占每周额度的一半),截至 11 月 16 日。
云端加本地:成本直接腰斩
很多人没把本地模型用起来,多半有两个顾虑:觉得自己的硬件跑不动,或者觉得本地模型写不了像样的代码。这位网友两个都有过,后来用 Qwen3.6-35B-A3B 写 Python,发现都站不住脚。
他的显卡是 RTX 4070 Ti Super,通过 llama-server 运行模型,跑起来之后只剩电费,按他自己测算,大约每百万 token 15 美分。
具体流程是这样的:
- 每个任务先让本地模型搭好初版:文件结构、主循环、核心类,以及刚好能跑起来的基础逻辑。
- 自己先运行一遍,看看大体能不能用。
- 再交给 Claude Code(Opus 5.5),对照需求检查、修错、补不足。
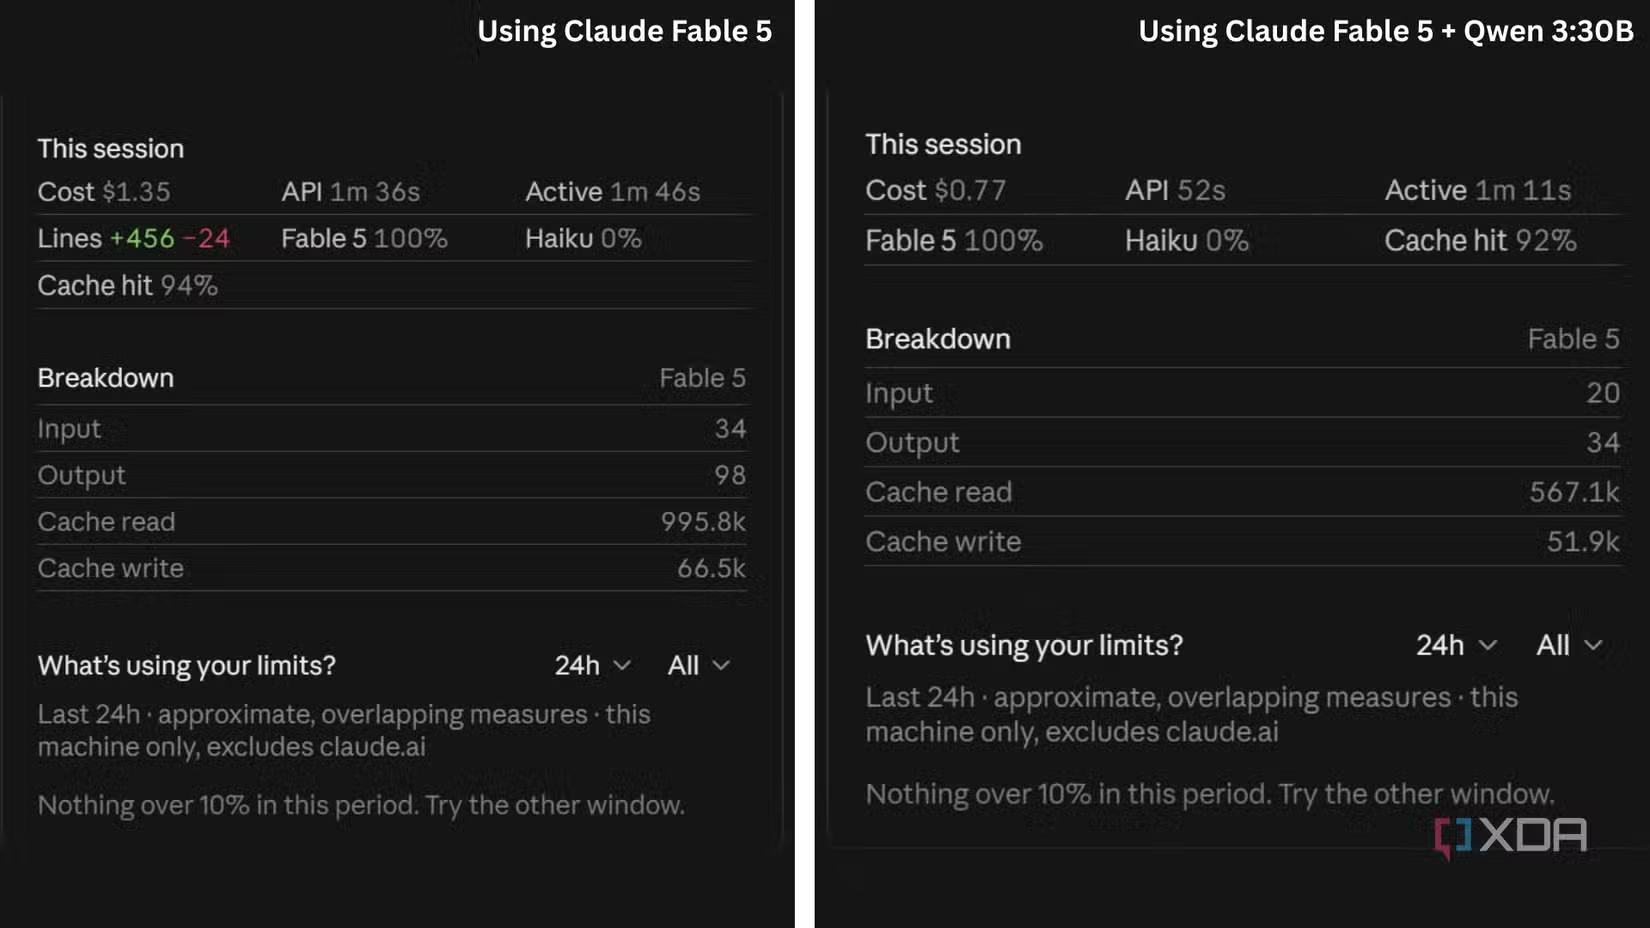
9 月他做过一个小行星(Asteroids)游戏复刻:先由早期的 Qwen 模型写出初版,再让 Claude 精修,花了 0.77 美元;如果全程让 Claude 从零写,要 1.35 美元,省了 43%。两边都用 Fable 5,差距完全来自 Claude 少做了多少活。
本地模型现在好搭多了
文本模型的搭建很简单:下载最新的 llama.cpp 发布包(Nvidia 显卡选 CUDA 版),解压后运行 llama-server,把它指向您的 GGUF 模型文件就行。要是觉得命令行吓人,LM Studio、Ollama 这类免费应用点几下就能完成全套设置,新手更友好。
除了写代码的第一稿,本地模型还能分担不少活。这位网友的本地组合是:
- FLUX 3 Image Klein:通过 ComfyUI 生成图片;
- Qwen3.6-35B-A3B 和 Gemma 4:处理日常问答,比如整理账单、理清财务;
- Nemotron Bolt:配合 Hermes Agent,帮忙做保持软件更新这类日常杂活。
本地没有五小时限制,但也别指望它替代云端
前沿云端模型强大、快,还能调用各种工具和 MCP,但贵、数据要出云,而且额度会卡住您的工作流。本地模型能力赶不上前沿模型,胜在随用随有、成本低。小编的看法和这位网友一致:别二选一,找到两者之间的平衡点,钱包和效率都能照顾到。想了解更完整的对比,可以看看 16GB 显卡跑本地 Qwen3.6 对比 Claude Code 的实测;想学两段式流程,也可以参考 OpenCode 加 VS Code 的两段式 AI 编程。
想自己动手的话,llama.cpp 的官方仓库有各平台的发布包和说明:llama.cpp 官方 GitHub。
常见问题(FAQ)
我的显卡一般,也能这么玩吗?
可以先从小一点的模型试起。本站也有 8GB 显存跑本地模型的实测,思路相通,只是模型规模要降一档。
本地模型写的初版,质量够用吗?
只要求“搭框架、能跑起来”就够了,细节和错误交给 Claude 检查。这位网友的小游戏案例里,省钱的关键就在这里。
怎么避免自动充值把账单越刷越高?
给使用额度设一个月度上限,别留着无限自动充值。这位网友当初没设,是账单失控的主要原因。
本地模型要花钱吗?
模型文件本身免费,运行成本只有电费。按这位网友的测算,大约每百万 token 15 美分。