
干活时突然想起一件事,心想“等会儿再做”,结果过一小时就忘了?小编也常这样。试过听写工具,但发现自己要的不是“打字更快”,而是让电脑听懂我边想边说的碎碎念,并整理成能用的待办。结论先说:用 Whisper 转写加 Qwen 3.5-9B 整理,全部在本地跑,一个 Python 文件搞定,只占约 7GB 显存,亲测好用。
思路:两个模型各干各的
小编工作时桌面上同时开着浏览器、Slack、Discord、编辑器、文件管理器,还有在测的游戏或跑分,念头冒出来很快就没了。后来小编不再让一个模型包办一切,而是分工:
- 录一条语音备忘;
- Whisper 在本地把语音转成文字,它只负责“听清”;
- 文字交给通过 llama.cpp 运行的 Qwen,它负责“听懂”,并输出结构化任务;
- 日期计算交给代码,不让模型算,因为“明天”这种事,几行确定性的代码比偶尔把明天当哲学概念的模型靠谱;
- 结果按时间自动排序,显示在桌面。
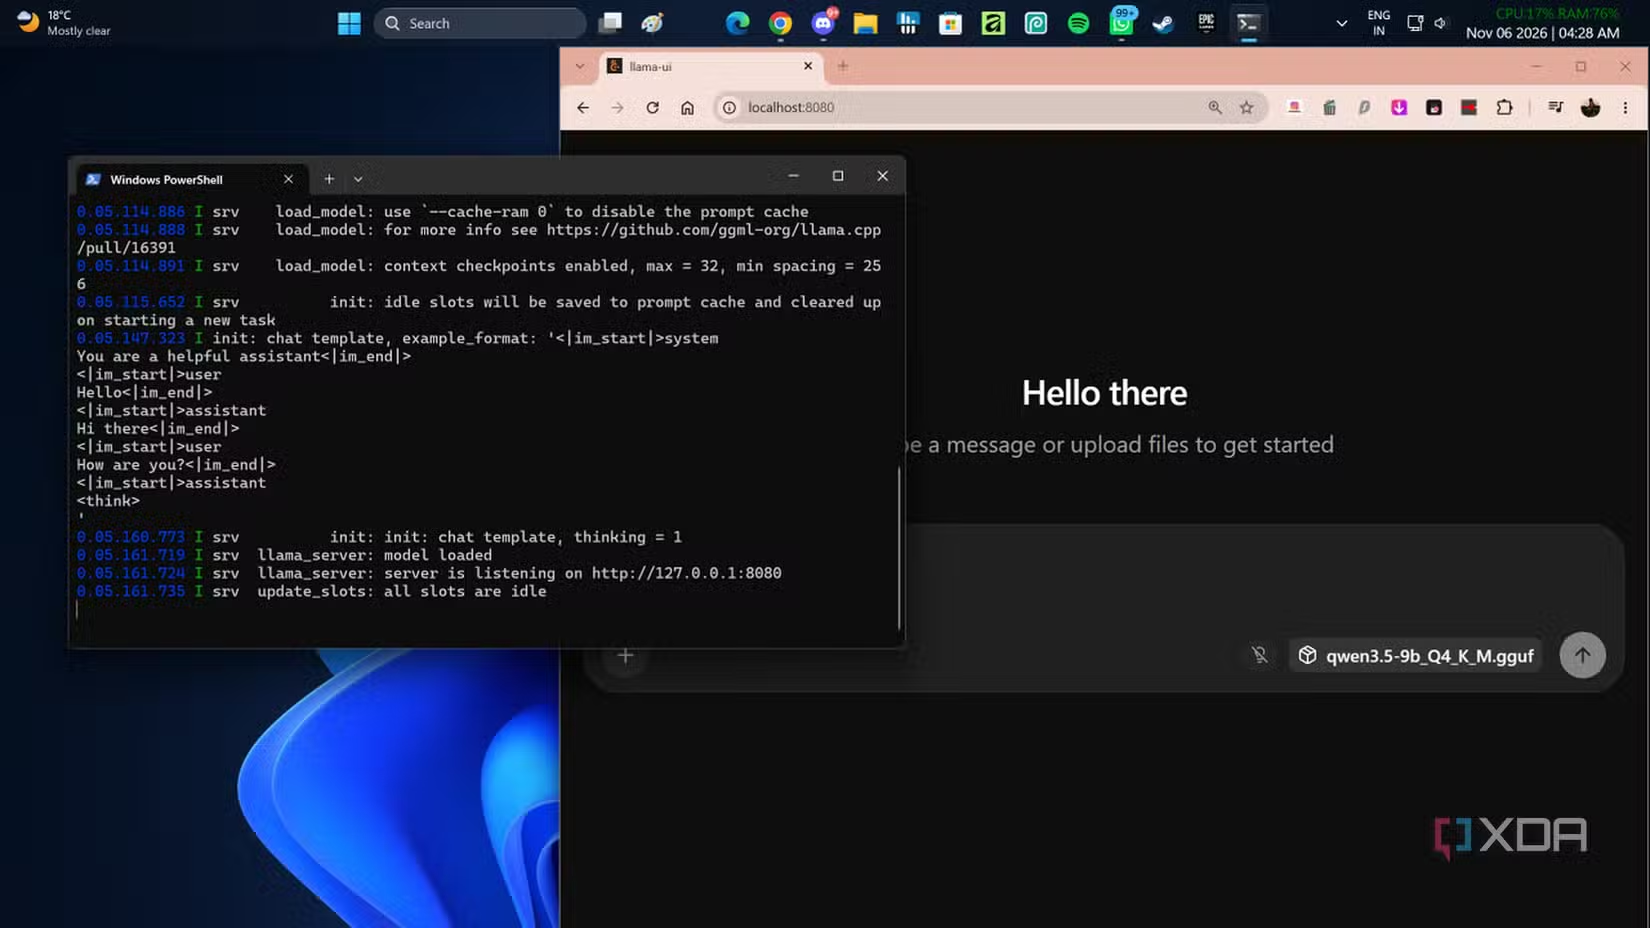
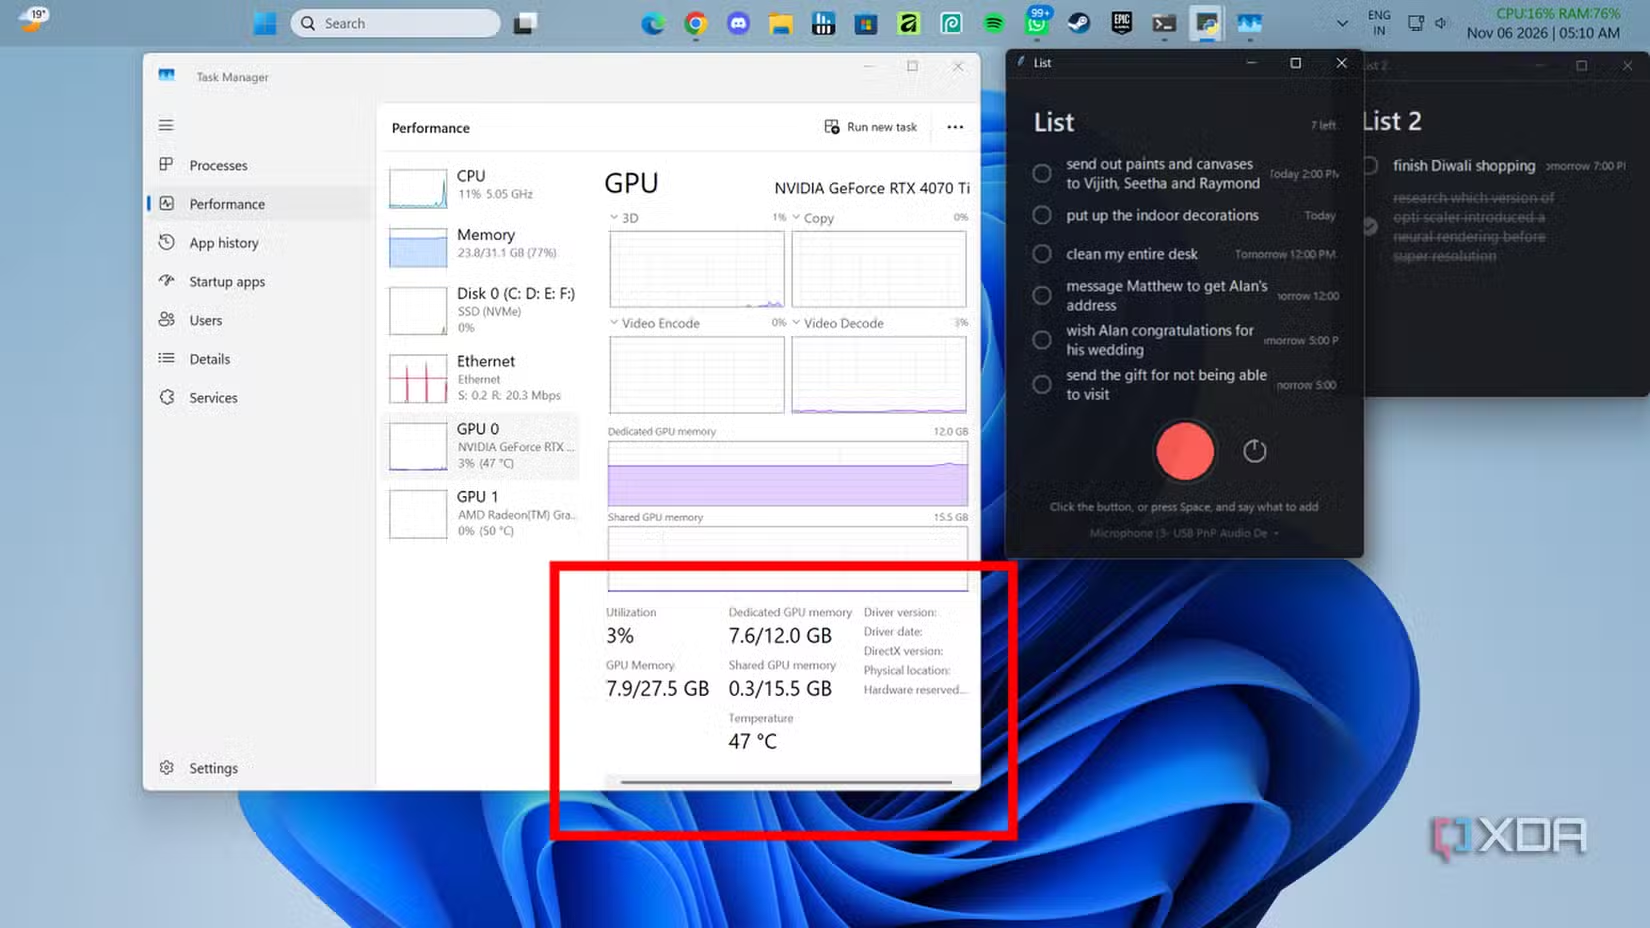
小编用的是 Qwen 3.5-9B 的 Q4_K_M 量化版(简单讲就是压缩过的版本,占用更小),在 12GB 显卡上跑得很顺。配上 Whisper,整条流程在 RTX 4070 Ti 上只用约 7GB 显存。
效果比较接近小编想要的:一条语音说“要给周末聚会订零食、彻底打扫房子、还要清洗空气炸锅”,会被拆成三条带时间的待办,自动按时间排序,不用事后再去“翻译”自己的语音。
别让流程太零碎:合并成一个 Python 文件
最初的设想步骤太多:打开 Windows 录音机、录音保存,再启动本地 llama 服务器跑 Qwen,还要让 Whisper 指向刚保存的文件。三个窗口互不相通,要靠人手把文件从一个搬到另一个。技术上能跑,但就像没座椅的汽车,“能开”而已。结果转写语音备忘本身成了一件麻烦事,有点讽刺。
所以小编把它们合并成一个 Python 文件:启动服务器、接入 Whisper、录音、转写、整理成待办,全部集中在桌面上的一个图形界面里。待办每批显示六条,像一张可以随意拖动的便利贴。
显卡干重活,转写交给 CPU
过程没那么顺利。faster-whisper 找不到音频库,也找不到 Nvidia 的数学库,装了好几遍都不行。最后小编干脆把转写放到 CPU 上:对 20 到 30 秒的语音备忘,CPU 几秒就完成,没必要硬让显卡接手,显卡专心托管模型就好。
这里 Claude Code 帮了大忙,一轮轮迭代代码,让小编可以直接在界面里选择语音输入方式,还加了个开关,可以卸载 Whisper 和 Qwen 把显卡完全腾出来;下次按下录音键,服务器和模型会自动重新启动。
为什么坚持本地运行
理由很简单:这些是自己的想法,没必要为了变成待办清单而离开自己的电脑。小编每天在电脑前待 14 小时,麦克风就在桌边。中间没有云端 API,也不用多交一笔订阅费。当然也有不足,偶尔会听错或写错人名,显卡重新上线时有短暂的预热停顿,但这些取舍可以接受。想自己试,可以看 Whisper 项目主页 和 llama.cpp 项目主页。
常见问题(FAQ)
没有独立显卡能用吗?
转写在 CPU 上就能跑,但 9B 模型整理任务会慢不少,小编没在纯 CPU 上测过。
为什么不用一个模型搞定?
目前分工更稳:Whisper 专心听,Qwen 专心理解。以后单模型的语音系统成熟了,会更简洁。
日期为什么不让模型算?
模型偶尔会算错日期,用代码计算“明天”“下周”更可靠。
会不会听错名字?
偶尔会,这是目前最明显的缺点,人名要留意核对。