
用过 Claude 的人,多半遇到过“漂移”:您在第一条消息里定了规矩,哪怕只是回复的格式,十几轮之后它就开始松动;再往后,它可能答非所问,或者突然同意自己之前反驳过的观点。
这里说的不是上下文用完的那种情况。漂移在会话早期、甚至短会话里也会发生,指的是对话离您最初的指令越来越远,而会话离“塞满”还远得很。有用户总结出了几个把它拉回来的办法,而且跟“把提示词写得更好”关系不大。
结论先说:规矩写进项目说明里、改消息而不是追加纠正、第二次纠正时就开新对话,这三招比反复在聊天里提醒管用。
Claude 的漂移问题到底是什么
它和“上下文用完”不是一回事
漂移就是对话渐渐偏离您的指令、您让它记住的具体信息,或者整个会话的主题。Anthropic 公布过一个相近的测试 MRCR v2:在一百万 token 的对话里藏入八个几乎一样的请求,然后让模型复述其中某一个请求的回答。据 Anthropic 披露,Opus 4.6 在 2 月发布时这项得分为 76%,同一测试里 Sonnet 4.5 只有 18.5%。
这位用户日常主要用 Opus 系列,漂移仍然会发生。他认为更强的模型有帮助,但帮助多大不好说,因为 MRCR 测的是“能否找出埋在对话里的内容”,不是“能否一直照您的要求做”。
微软与 Salesforce 的一项研究模拟了 20 多万次对话、涉及 15 个模型(含 Claude 3.7 Sonnet),发现任务分散在多条消息里时,模型平均表现比一次性给全信息差约 39%,强模型和弱模型的降幅差不多。另有《Lost in the Middle》这篇论文发现,模型对信息的利用,在内容开头和结尾最好,在中间最差。这对会话中途发的提醒和纠正是个坏消息,因为它们恰好都落在“中间”。
这位用户最烦的一个例子是破折号。AI 回复里的破折号已经成了“机器人腔”的标志,他得一遍遍告诉 Claude 别用,因为它总在会话中途把这条指令丢掉。下面几招,是他找到的更有效的办法。
把规则从对话里搬出去
说一次,让 Claude 每次都能看到
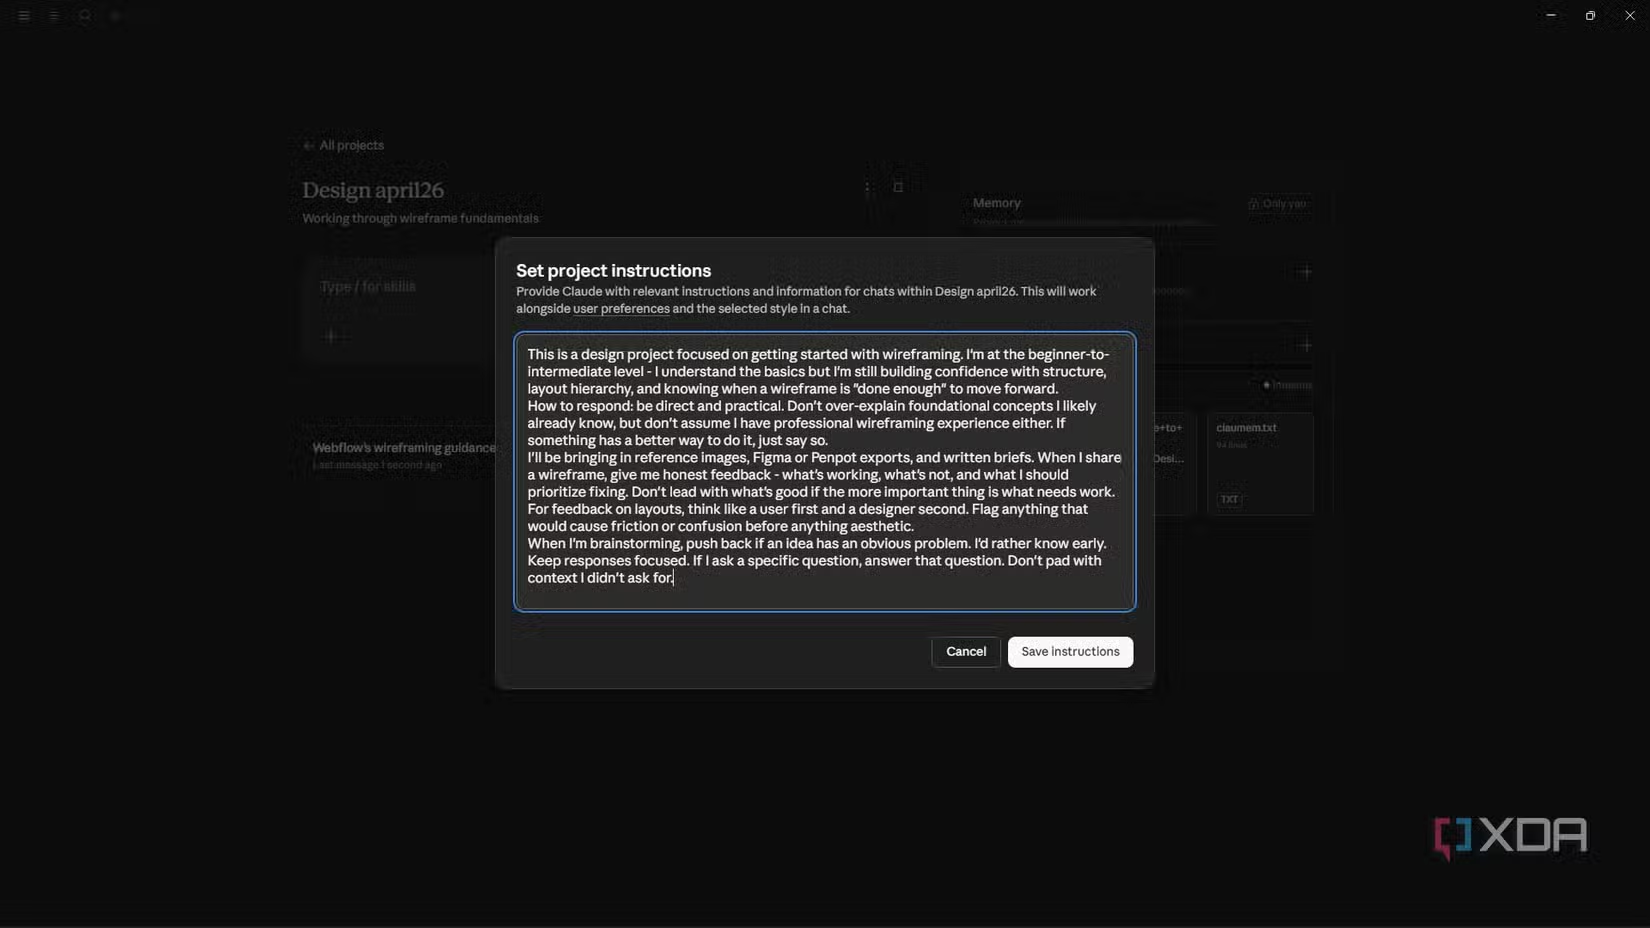
Claude 聊天里,最接近 Claude Code 中 CLAUDE.md 文件的东西,就是项目说明(Project instructions)。写在那里的内容适用于该项目下的每一个对话,通常比写在第一条消息里的规则更稳。如果不想用项目,也可以在单次会话里上传一份规则文档,但您可能要中途提醒 Claude 看文档,或者重新上传一次。
项目更有效的原因,还是那个“中间”问题:您在对话里输入的规则,会随着聊天变长被推得越来越靠后;而项目说明在对话开始前就已就位,每次回复都会参考。另外要注意,如果您往项目里上传了大量文件,文件接近容量上限时,Claude 会改用检索(RAG),只搜索相关片段,而不是完整吸收。
编辑那条消息,而不是再发一条
它起到的作用,有点像“撤销键”
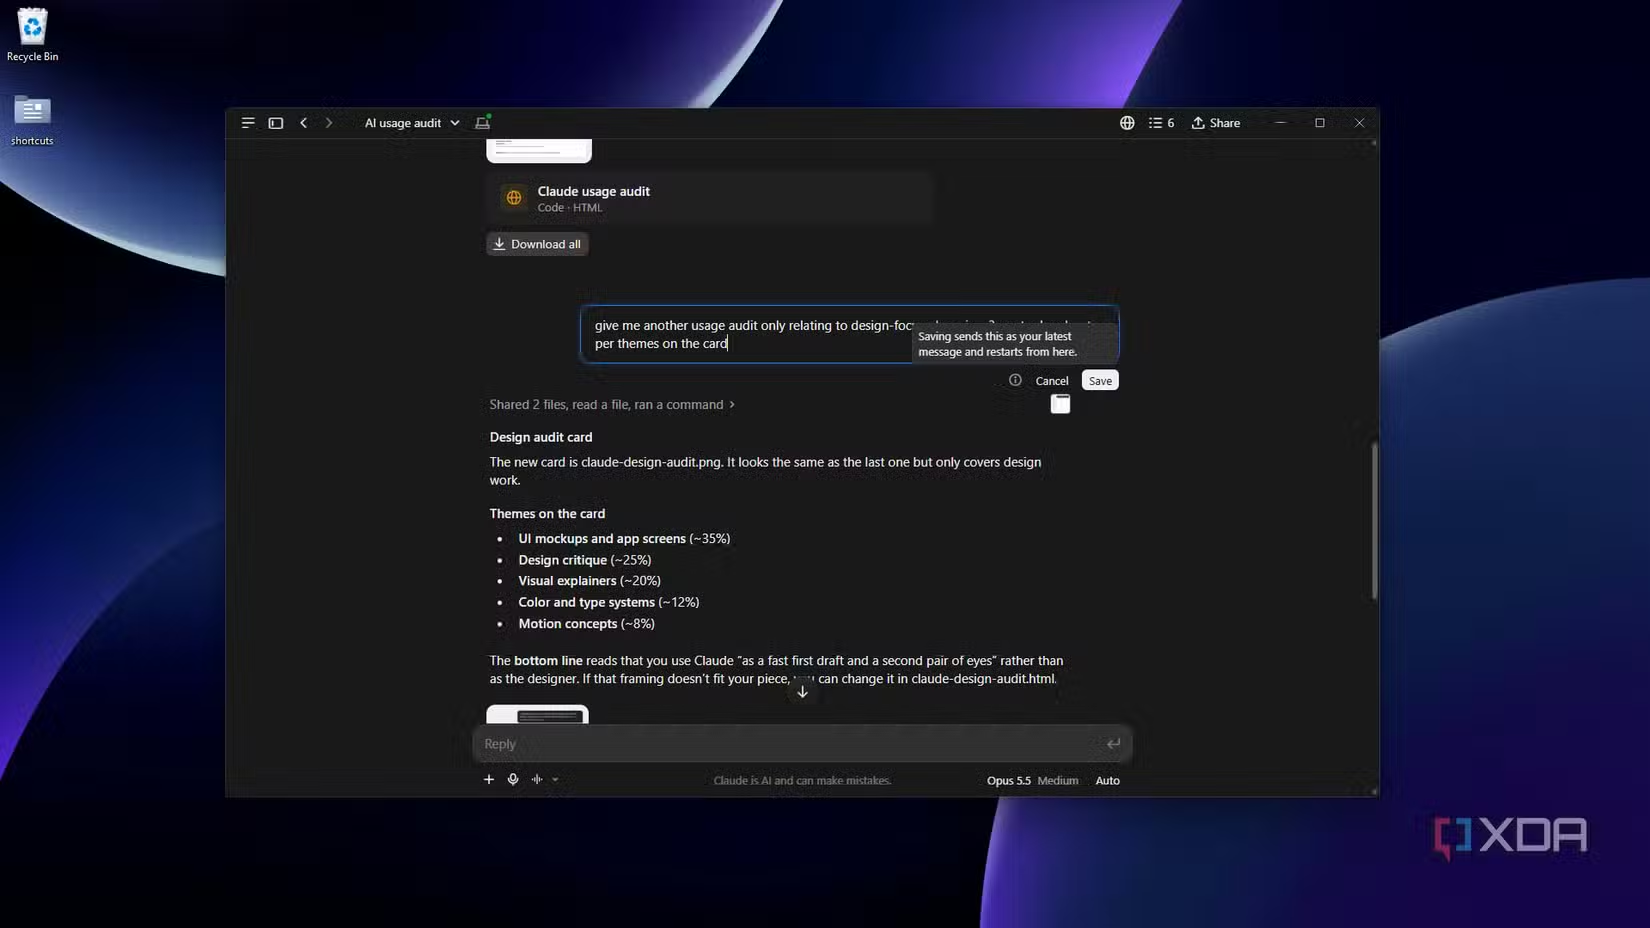
回复出了问题,我们的本能是打字纠正。可这样做会把错误回复和您的抱怨都留在对话里,Claude 在后续每条消息里都会重读它们。前面提到的微软与 Salesforce 研究发现,模型很依赖自己早期做出的假设,而一次纠正并不会让这个假设消失。
更好的办法是用编辑功能。Claude 会在编辑器里提示,保存修改后的消息会创建一个新的对话分支:新分支保留您被编辑那条消息之前的所有内容,然后从新版本的消息接着往下,不再带上第一次紧跟其后的那条错误回复。
以前能用箭头回到旧分支,但新的界面更新似乎把箭头去掉了,这一点有用户觉得是缺陷。不过“得到一张干净的白纸”这个效果仍然有效。Anthropic 没有明说旧分支是否完全不会被新分支读取,按分支的通常逻辑应该是不读的。用户自己的体验是,漂移确实改善了,所以错误回复至少在一定程度上没有带进新分支。
别再纠正了,重新开始
某些对话已经救不回来
当需要第二次纠正 Claude 时,这位用户就知道该换新对话了。他会让 Claude 写一份简短的交接摘要:会话在做什么、已经决定了什么、现在进展到哪里,然后把摘要粘贴到同一项目里的新对话中。
这看似显而易见,却有研究支持。在前面那项多轮对话研究里,把所有信息一次性放进全新的提示词,模型能恢复到约 95% 的最佳表现;而在原对话末尾做一次总结,只提升了大约 15% 到 20%,没有回到一次性提示的水平,这基本就是“在旧聊天后面加一段摘要”的效果。
还有个额外的好处:新对话有全新的上下文窗口。Anthropic 说过,自动上下文管理启动后,更长的对话会占用更多使用额度,所以重开对话还能省一点额度。
好结果不一定来自更聪明的提示词
这位用户的体会是,Claude 就算您没时间、甚至没有能力把每个细节都精心写成提示词,也能推断出您想要什么,所以更好的结果往往不靠更巧妙的提示词。这些修复办法都很简单,恰恰因此容易被忽视。下次再遇到会话跑偏,与其在聊天里发火,不如试试新建分支,或者开个新会话并放进项目里。
如果您也在为 Claude 的使用额度发愁,还可以看小编之前写的 Claude 额度总不够用?让本地显卡先写代码;想给本地模型写系统提示词,可以参考 给本地大模型写段系统提示词,让它说话像 Claude。
常见问题(FAQ)
Claude 漂移是不是因为上下文用完了?
不是。上下文用完是另一种情况;漂移在会话早期或短会话里也会发生,指的是逐渐偏离您最初的指令。
项目说明和第一条消息里的规则有什么区别?
项目说明在对话开始前就已存在,并在每次回复时被参考;第一条消息里的规则会随着对话变长被推到“中间”,更容易被忽略。
编辑消息真的比再发一条纠正更好吗?
对用户来说是的。编辑会创建新分支,不带上之前那条错误回复,能得到一个相对干净的起点;追加纠正则会把错误回复留在对话里。
什么时候该开新对话?
按这位用户的做法,需要第二次纠正 Claude 时就该开新对话。可以先让它写一份交接摘要,粘贴到同一项目的新对话里。
换更强的模型能彻底解决漂移吗?
不能保证。更强的模型可能有帮助,但相关研究显示强模型和弱模型在多轮对话里的降幅相近,所以还是要靠合理的使用方式。