
显存只有 8GB,本地大模型基本只能在 4B 到 9B 之间打转。每隔几周 Hugging Face 上就冒出更大的新版本,下载下来要么塞不进显卡,要么一半跑在内存里,回答一个字一个字往外蹦。
这篇文章的原作者后来换了思路:不再盯着参数量,而是挑”为自己硬件优化过”的模型。结果他下载的 Bonsai 27B,在 8GB 显卡上跑得跟 4B 模型一样顺。小编把原文整理了一遍,咱们看看这个 8GB 显存跑 27B 本地大模型的思路到底靠不靠谱。
Bonsai 27B 是什么,为什么 8GB 够用
简单讲,Bonsai 27B 是 PrismML 做的压缩版 Qwen 3.6 27B。原版模型大约 54GB,Bonsai 的 1-bit 版本把每个参数压到大约 1 比特,体积降到 4GB 左右。(所谓”量化”,大白话就是给模型”瘦身”,用更粗的数字存参数,换来更小的体积。)
据原作者介绍,PrismML 还有三值(ternary)版本和更新的 Bonsai 2,体积在 5 到 7GB 左右,三值版本几乎要占满一张 8GB 的卡,所以 1-bit 版更合适。
| 版本 | 体积(原文数据) | 8GB 显卡上的情况 |
|---|---|---|
| 原版 Qwen 3.6 27B | 约 54GB | 放不下 |
| Bonsai 27B 1-bit | 约 4GB(含视觉文件约 5GB 内) | 可以整个放进显卡 |
| 三值版 / Bonsai 2 | 约 5 到 7GB | 三值版几乎占满显存 |
原作者在 LM Studio 里搜到它,还是官方”编辑精选”(Staff Pick),含视觉文件的整包不到 5GB。整个模型都能放到 GPU 上,同时上下文还能开到 30k 左右,对本地模型来说已经不短了。模型本身支持最长 262K,但日常根本用不到。
设置上的一个小坑
Bonsai 会先”思考”再回答。原作者一开始沿用旧预设,把思考长度限制在 1024 个 token,结果回答说到一半被截断。换成接近 PrismML 推荐的新预设就好了。所以换模型时,别忘了同步检查参数预设。
日常问答:适合处理隐私内容
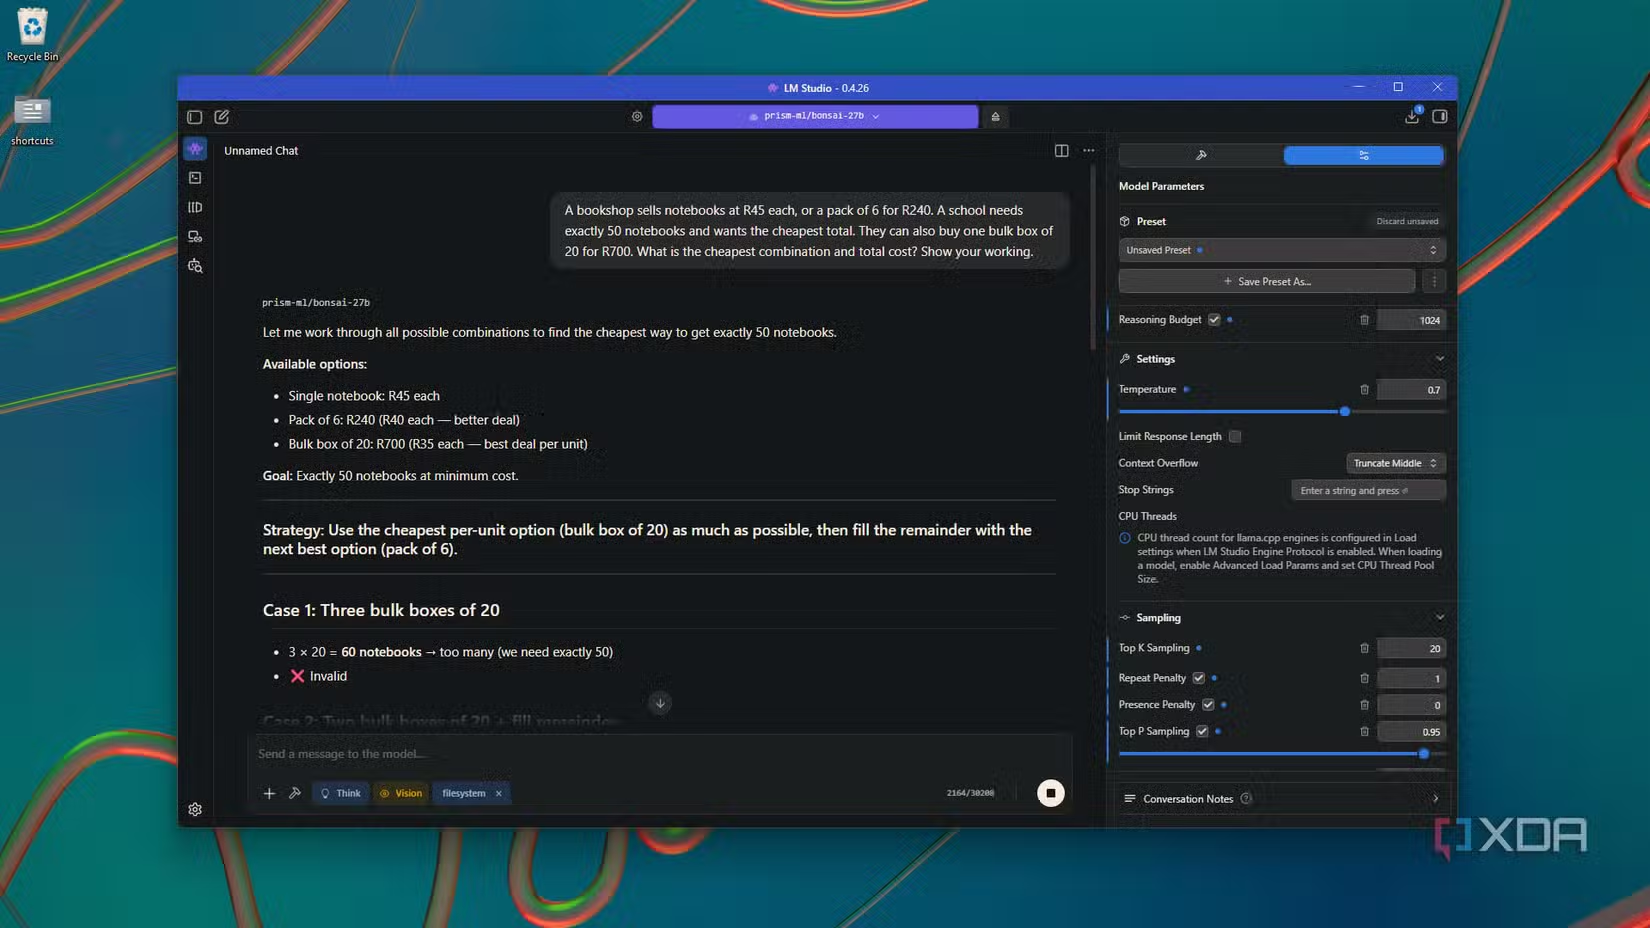
原作者问本地模型的,大多是些不算正经工作的日常问题,但常常涉及健康、财务文档这类不想上传云端的内容。这正是本地模型的价值所在:数据不出自己电脑。
- 语气比较温和:原作者觉得有点像 Gemma 4,甚至接近 Claude 的 Sonnet,有时还会反问一句,把对话接着聊下去。
- 数学不错:官方给的 GSM8K(一套日常数学应用题的测试)成绩是 92.8,核对财务文档里的几组数字够用。
- 听系统提示的话:比如要求”只写短段落,不用列表”,它能在整段对话里一直遵守。
- 常识类要多留心:据 PrismML 自己公布的数据,压缩对通用知识影响最大,重要事实最好自己再核对一遍。
另外它同时支持”思考”和”视觉”。原作者自己习惯关掉思考模式,理由是它吃上下文太多,不值得。
接入 Cherry Studio、Open Design 和 MCP
Cherry Studio:本地和云端混着用
原作者把 Bonsai 接进了 Cherry Studio,这是一个功能比 LM Studio 更全的 AI 工作台,能做自定义助手。Cherry Studio 里还放着他的 Claude 和 GPT 密钥,所以同一个工作区里可以切换:重活交给云端 API,涉及隐私的活交给本地模型。它还能把同一个问题同时发给多个模型,方便对比本地模型和云端模型的差距。
Open Design:写代码并不拉胯
Open Design 是开源的”Claude Design”类工具,同样能通过自带密钥的方式连上本地模型。原作者知道编程不是 Bonsai 的强项,但试了之后觉得没想象中差:让它做一个手机登录页,成品算不上惊艳,不过他的提示词写得很粗(怕撑爆上下文),模型对原型怎么搭还是有基本概念的。唯一的问题是速度偏慢。
MCP:文件系统行,联网搜索得手把手教
MCP 简单讲就是给模型”装工具”的通用接口,比如让它读取您电脑上的文件夹。LM Studio 支持 MCP,原作者测试了文件系统 MCP,Bonsai 知道什么时候该自己调用工具,也能理解文件和笔记的内容。
短板在联网:它分不清什么时候该搜索,每次都得明确告诉它去用 Brave Search MCP,否则连今天的日期都答不对。能搜是能搜,但”自己判断要不要上网”这一步没做到。
8GB 显卡玩家的选择思路
原作者提到,最近有一批”稍大一点、又针对中低端硬件优化过”的模型:Qwen 3.5 9B、Gemma 4 12B、Qwythos 9B,Bonsai 27B 正好补进这个阵容。他的结论是:自己大概还是会去看新出的大模型能不能塞进显卡,但像 Bonsai 这样的模型已经覆盖了他日常的大部分需求,没必要再硬追参数。
小编的看法:选模型先看三件事,能不能整个放进显存、上下文够不够、您的任务是不是它的强项。参数量排在后面。
常见问题(FAQ)
8GB 显存真的能跑 27B 模型吗?
用 1-bit 压缩的 Bonsai 27B 可以。原作者的体积数据是约 4GB(含视觉文件不到 5GB),能整个放进显卡,上下文还能开到 30k 左右。
压缩得这么狠,答案会不会变差?
会有代价。据 PrismML 自己的数据,通用知识受影响最大,所以事实类的回答建议自己核对。
它适合写代码吗?
不是强项。原作者拿它做简单原型,效果能接受但速度慢,复杂开发还是交给更强的云端模型更稳。
思考模式要不要开?
看上下文预算。原作者平时关掉,因为它消耗的上下文太多。要开的话,记得把思考长度的上限放宽,否则回答会被截断。
它能自己上网搜索吗?
接上搜索 MCP 就能搜,但需要您每次明确提示,它自己判断不准。
总结
Bonsai 27B 的价值在于:把 27B 级别的模型压进 8GB 显卡,日常问答、算数、读文件都够用,隐私内容也不用上云。短板是通用知识、自动联网判断和编程。如果您也是 8GB 显存,值得在 LM Studio 里试一试。本文数据均来自原作者的使用体验及其引用的官方数据,小编未能逐项独立核实,具体以官方说明为准。想看设备更小的情形,还可以读读 8GB 的 MacBook Air 离线跑能看能听能说的 AI。