
AI 订阅已经够多了,所以当一个被称作“开源版 ElevenLabs”的项目在 GitHub 上突破 11 万颗星,有位用户想知道它能不能顶替一个订阅。VoiceStudio 声称声音克隆、视频配音和转写都在自己的电脑上完成,不需要账号。他把它装进了台式机的 WSL2,并搭配 AMD 的 Lemonade 本地模型服务,克隆了自己的声音,把一段德语纪录片配成英文,最后还断网从头跑了一遍。小编先说结论:能用,断网也能用,但配音出来的翻译必须人工校对,另外有几处坑值得提前知道。
安装路线:WSL2 里的 Ubuntu,同时装下 VoiceStudio 和本地大模型
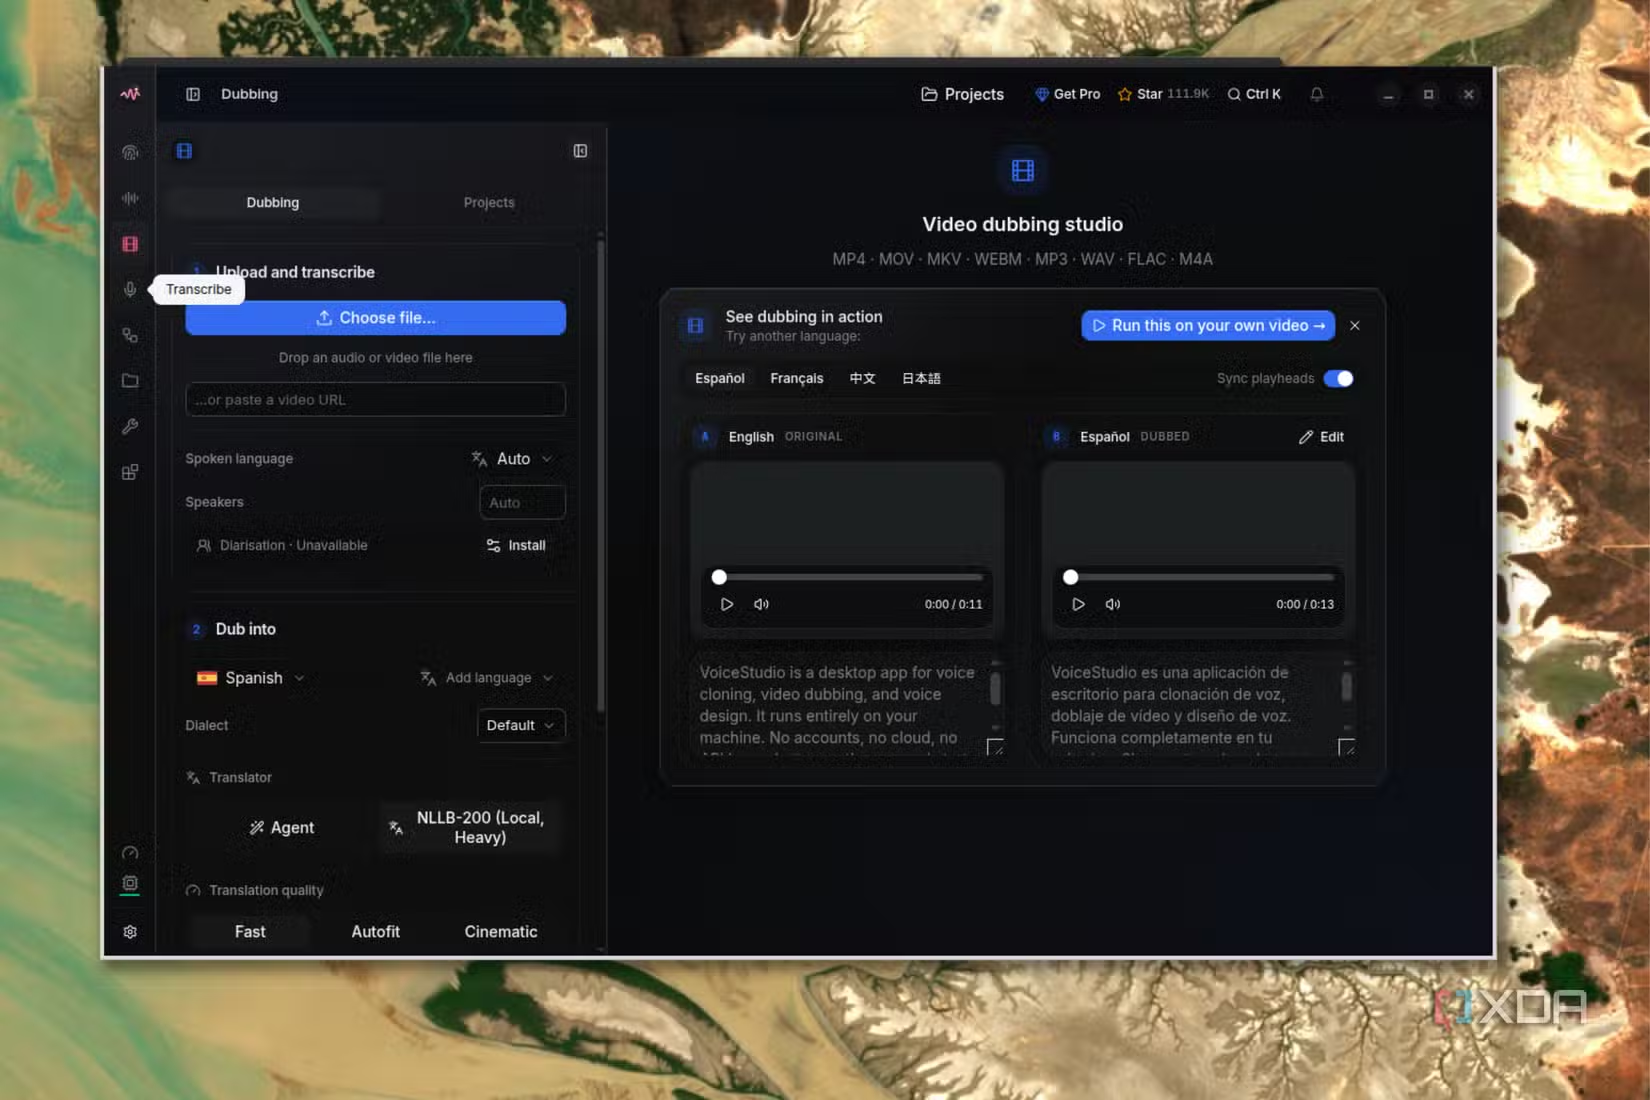
这位用户的测试机是 Ryzen 7 9850X3D 加 RTX 5090(32GB 显存)的台式机。VoiceStudio 有 Windows 安装包,但据项目的代码签名政策,Windows 安装包暂时没有签名,签名申请还在审批中,他不想为此和 Windows 纠缠,就直接走 Linux 路线。Linux 版支持 CUDA,WSL2 又能把 Nvidia 显卡暴露给 Linux,于是 VoiceStudio 0.5.8 用一条命令装进了 WSL2 的 Ubuntu 24.04 LTS。
第一次安装看着已经完成了,其实没有:安装脚本还在后台下载 Python 环境,完成之前应用的本地端口没有任何响应。所以回到命令提示符,不代表已经就绪,得多等一会儿。
VoiceStudio 自己能处理语音,但更聪明的配音模式需要一个大语言模型来润色翻译。他在同一个发行版里,用软件源装了 Lemonade Server,加上 CUDA 后端,拉取了 Qwen3.5-9B(Q4 量化,约 6.4GB)。两个服务共用同一个回环地址,不用在 Windows 和 Linux 之间搭桥。
模型有一处需要调整:让它翻译一句德语问候,它用了 281 个 token,几乎全是在“思考”,才给出五个词的答案,耗时约 2 秒。把推理关掉重新加载就解决了:
lemonade load Qwen3.5-9B-GGUF --llamacpp cuda --llamacpp-args "--reasoning-budget 0" --save-options同样的提示词,这次只用 10 个 token、87 毫秒。别小看这点差别,累积起来很可观:他翻译一段 15 行的片段时,Lemonade 已经记录了一百多次请求。
两者在设置页里连接:设置 → 系统 → LLM 提供商,选“自定义(Custom)”,基础地址填 http://127.0.0.1:13305/api/v1,再输入模型名。他第一次把地址粘进了模型名那一栏,结果得到 404,所以报错前先看看剪贴板里到底粘了什么。
声音克隆:30 秒录音就够了
他朗读了《爱丽丝梦游仙境》的开头(属于公共领域作品,也应了“掉进兔子洞”的景),剪成 30 秒导入,再让克隆的声音朗读别的内容。他形容效果“有点吓人”:连语速、音高、口音,甚至呼吸声都复制了,而呼吸声正是让它从“朗读”变成“说话”的关键。他也坦言,这么容易,自己不太喜欢。
速度也不慢:他用一个小脚本向 VoiceStudio 的本地接口发送一段 58 个词的文字,RTX 5090 用 2.3 秒生成了约 20 秒的语音,大约是实时速度的 8.6 倍。
它并不完美:第一次使用时,没录过的词“mini PC”被读成了奇怪的发音,带“s”结尾的词也拖得很长,三次都是同样的毛病;某个内置声音读对了“PC”,听起来却有金属感、明显是合成的。后来干净重启之后,他的克隆声音读对了,说明这个问题不是永久的。重新生成没能解决,重启应用才解决。
视频配音:比想象中更需要手把手
配音测试用的是 ZDF 《Terra X》系列里一段 1 分 45 秒、讲阿尔卑斯山如何形成的科普短片。该系列以知识共享许可发布视频,这一段采用 CC BY 4.0。VoiceStudio 把它转写成 15 个片段,生成英文音频花了约 15 秒,整个 GPU(含大模型)约占 10GB 显存。
第一遍配音听起来像德国人在念英语,有些句子前还有多余的辅音。第二次导入时,有个差点被他忽略的弹窗提示:自动声音克隆被跳过了,因为说话人标签只是根据音频间隙估算出来的,并建议使用说话人分离模型。他于是用旁白者自己的音频做了一个声音档案,手动指定,效果清晰了很多,只是某些词前面还有轻微的嘶声。
翻译需要校对。几轮下来,9B 模型大多数句子译得不错,但有一次翻错了一句,还有一句干脆没翻译、只是换了种德语说法。VoiceStudio 照样把那句德语念了出来,内置的检查器只提醒了一句时长偏紧。
另外,应用缺少进度提示:导入视频后在转写出现之前屏幕上什么都没有,他不止一次以为失败了,其实只是还在处理。
断网测试:声音克隆和配音依旧能跑
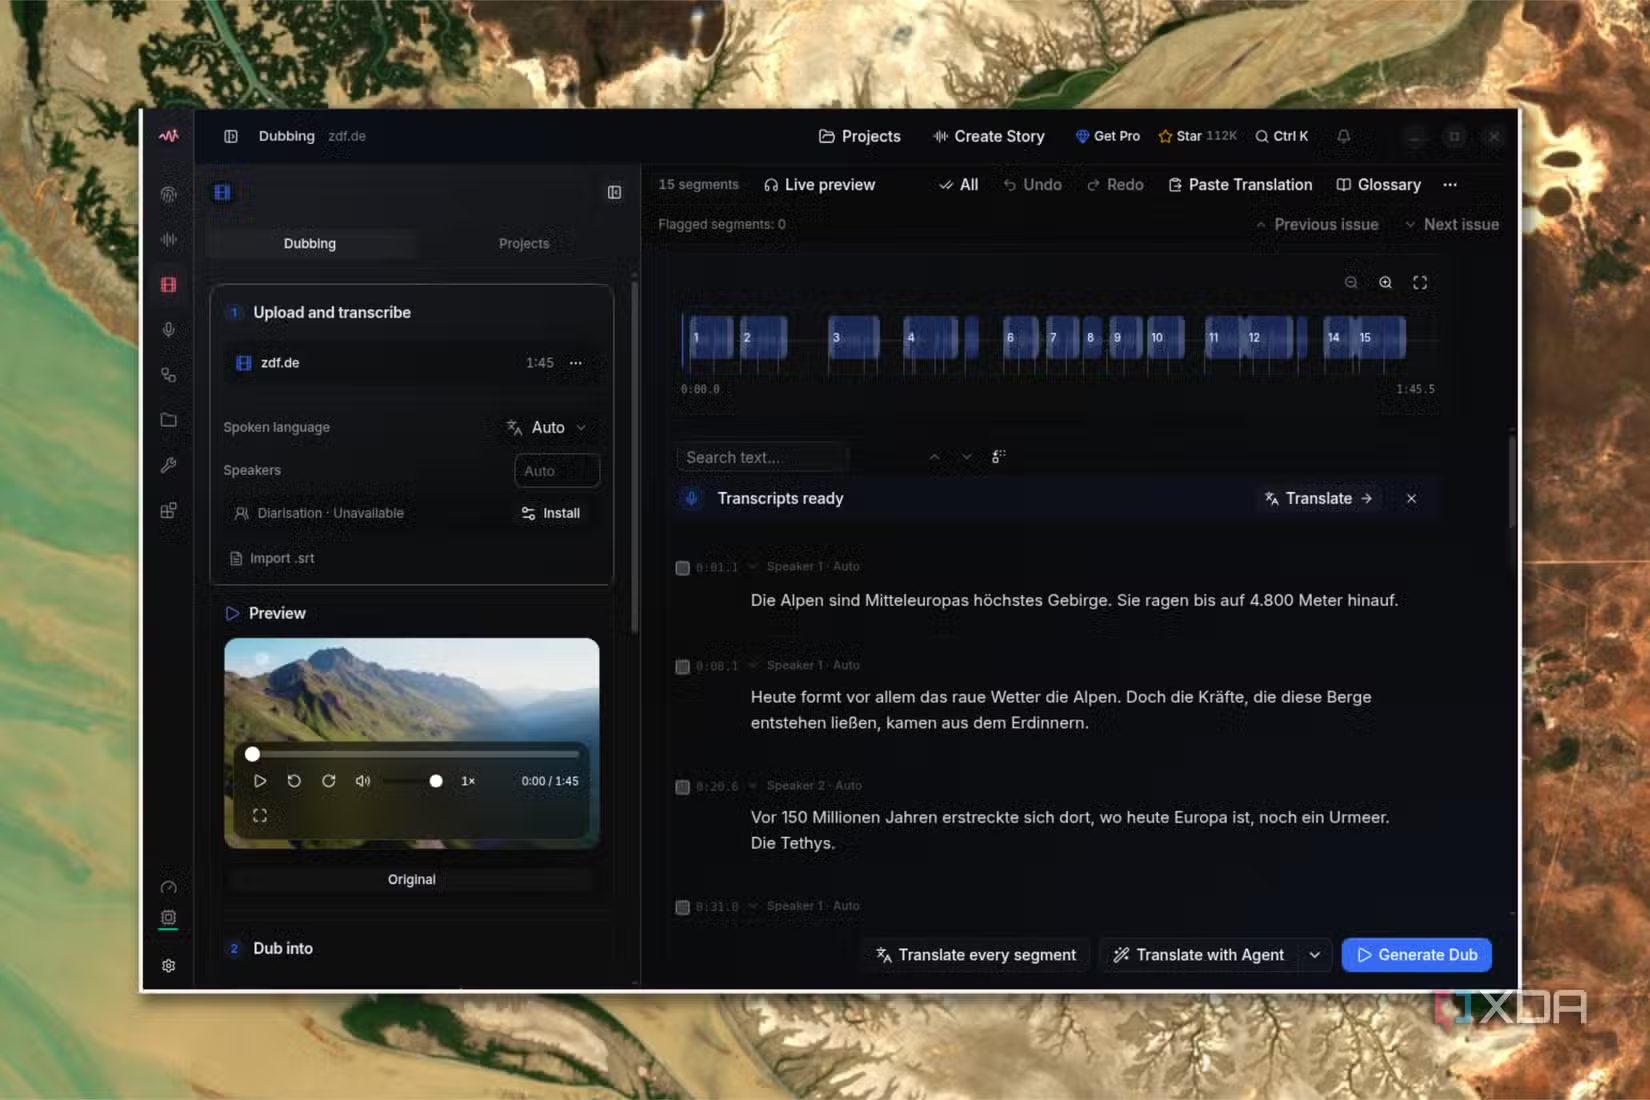
真正的考验是:他关掉电脑的 Wi-Fi 网卡,确认连 GitHub 都打不开,然后重启 VoiceStudio,从头跑完整条链路:导入本地的视频副本、转写、通过 Lemonade 翻译、套用自己的声音克隆、配音。全程没有报错。
这也是他最干净的一次:翻译和配音都没有听出问题。生成速度略慢,同样 20 秒音频用了 3.1 秒,约为实时的 6.3 倍,他也说不清原因,断网理应不影响速度,不过仍然比听结果的时间快得多。
这才是他在意的测试:下载模型当然需要联网,但对任何语音工具来说,真正的问题是录音在处理过程中去了哪里。这里他的克隆声音、视频、转写稿和译文,全程都没有联网。“无需账号”的承诺只有一处例外:说话人分离。弹窗引导他去用 pyannote,而 pyannote 的模型页要求登录 Hugging Face 并接受使用条款,所以他跳过了这一步,改为手动指定声音。
小编的看法:适合谁,要注意什么
他没有把它和 ElevenLabs 并排对比,所以不会说“一样好”。能确定的是:一个免费应用,在自己已有的硬件上,用 30 秒音频克隆出声音、给视频配了音,而且断网仍能工作。别人已经做到用 5 秒音频、不需要 GPU 克隆声音,门槛实际上已经消失,所以请只克隆您有权使用的声音。
- 适合:有显卡、想取消语音订阅、重视数据不出本机的人;
- 要有心理准备:配音需要人工校对每一句译文,说话人分离需要额外配置;
- 别忘了合规:克隆他人声音前先取得同意,配音使用的素材也要确认许可。
想了解更多全离线的语音与多模态玩法,可以看 用本地大模型把语音备忘自动变成待办:Whisper + Qwen 全离线方案,以及 8GB 的 MacBook Air 离线跑能看能听能说的 AI:LFM3-Omni 实测。
常见问题(FAQ)
VoiceStudio 真的完全不联网吗?
下载模型需要联网。模型就绪后,这位用户断网从头测试,克隆声音和配音都能完成;但说话人分离所用的 pyannote 模型需要登录 Hugging Face 并接受条款。
为什么在 WSL2 里装,不用 Windows 安装包?
据项目的代码签名政策,Windows 安装包目前没有签名;Linux 版支持 CUDA,WSL2 又能使用 Nvidia 显卡,所以他选了这条路线。
配音的翻译可以直接用吗?
不建议。他的测试里出现过翻错和漏翻的句子,而且应用照样会把没翻译的句子读出来,生成前最好逐句检查。
克隆声音需要多长的录音?
他用的是 30 秒的录音,已经复刻出语速、音高、口音和呼吸声。
克隆别人的声音合法吗?
这涉及各地法律和当事人的同意,本文不构成法律意见。稳妥的做法是只克隆自己的声音,或取得明确授权的声音。